Stateless : Horizontalement scalable derrière un Load Balancer.
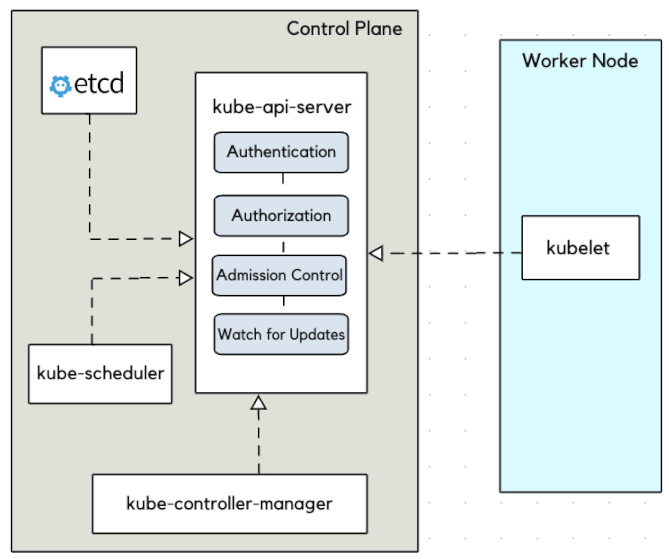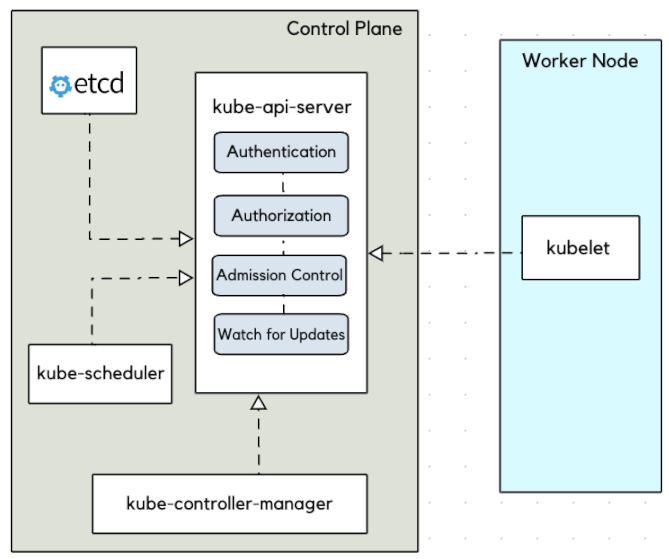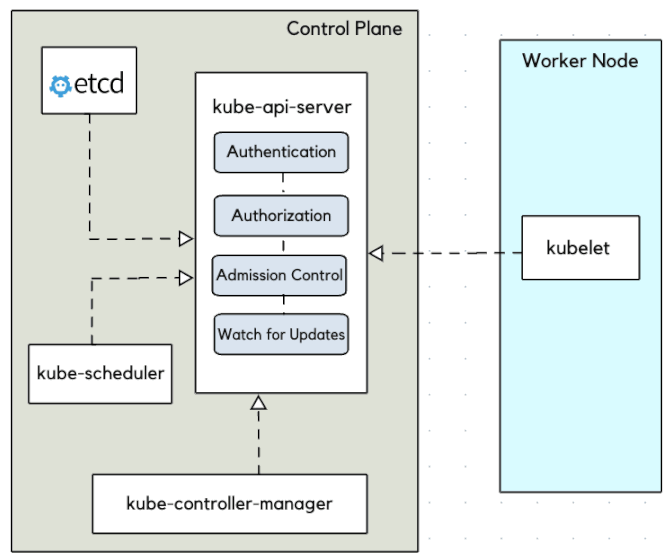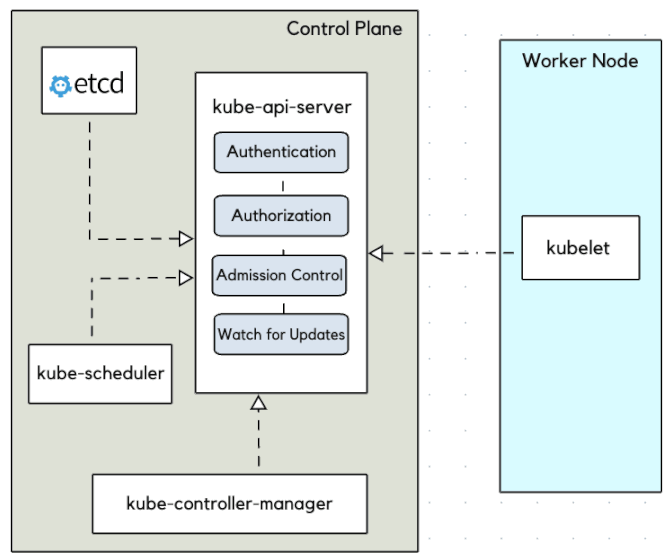
Émet des flux d'événements (watch) vers tous les autres contrôleurs.
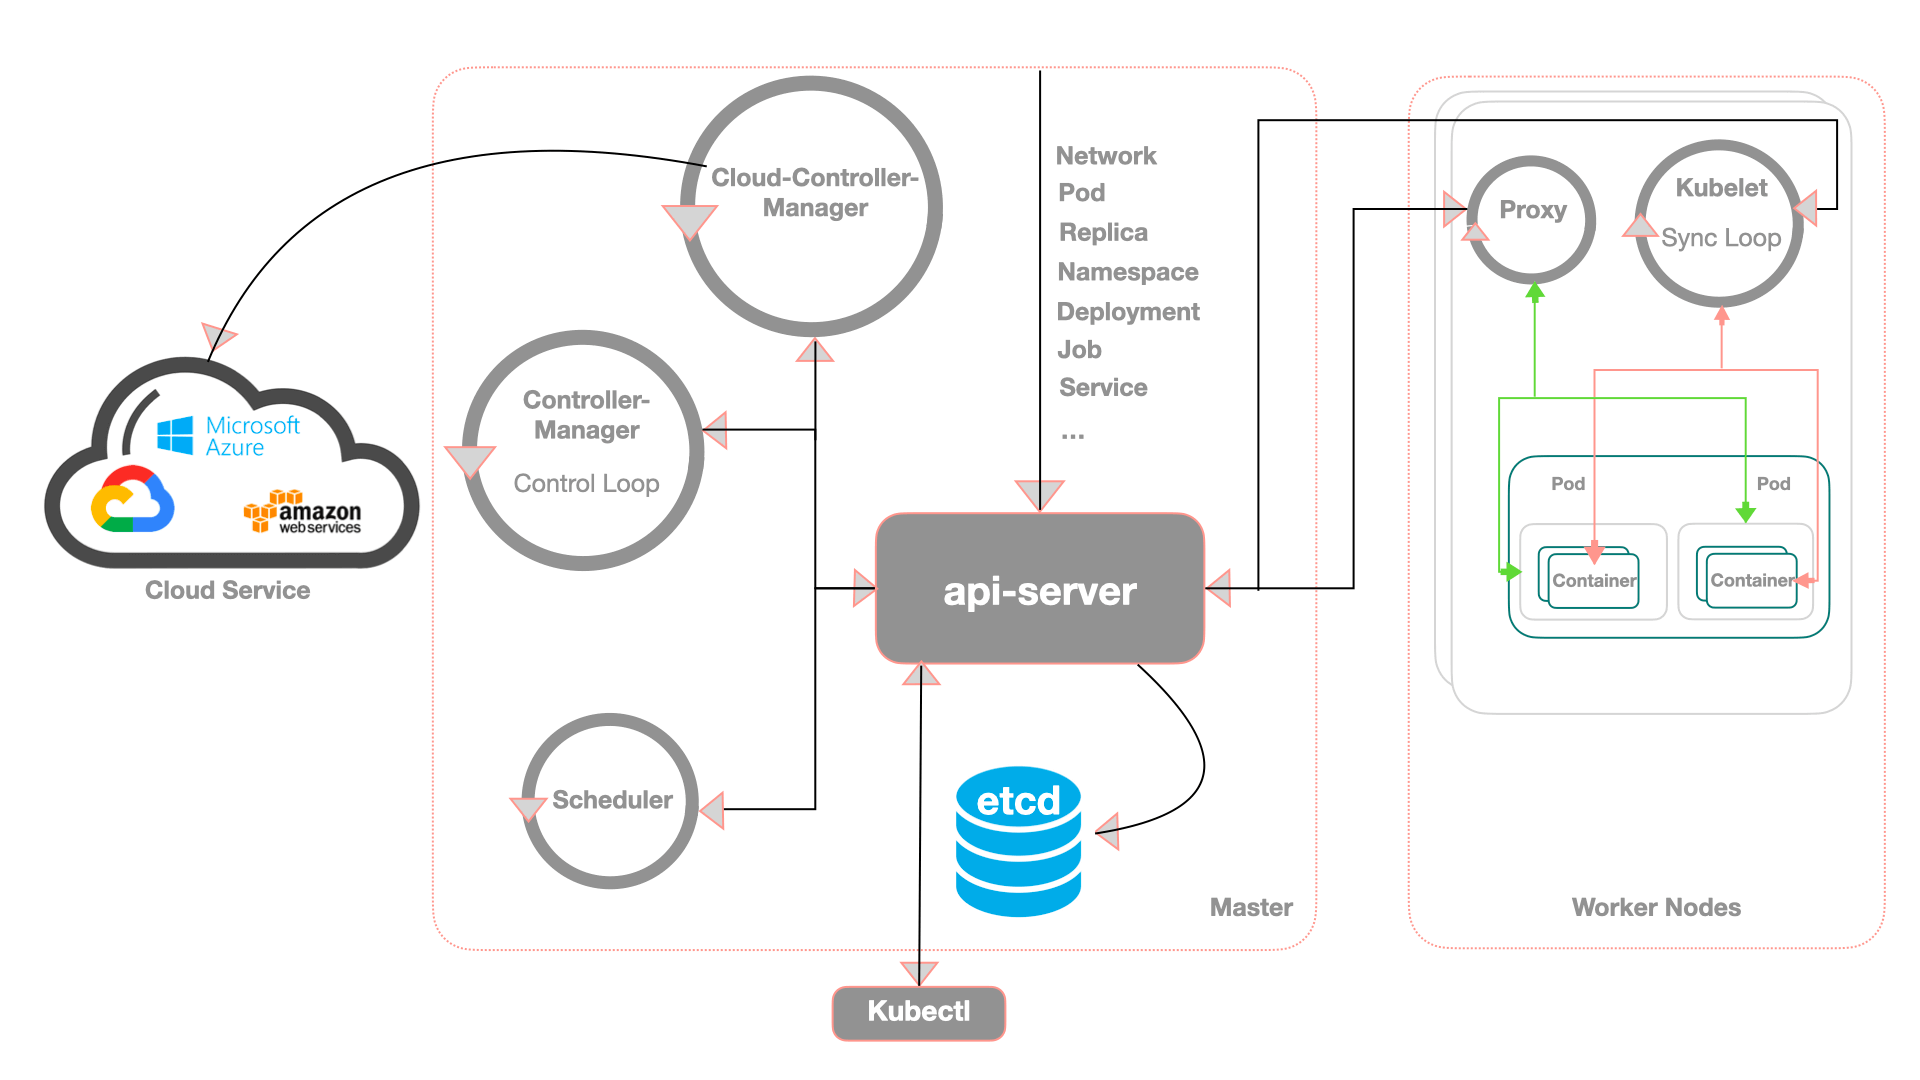
3. kube-controller-manager : La Boucle de Réconciliation
La promesse fondamentale de Kubernetes : Déclaratif vs Réel.
┌───────────────────────────────────────────────┐
│          LA BOUCLE INFINIE DE CONTRÔLE        │
│                                               │
│      1. Observer l'état réel actuel           │
│      2. Comparer avec l'état désiré (YAML)    │
│      3. Agir pour résorber l'écart (Reconcile)│
└───────────────────────────────────────────────┘
Regroupe des dizaines de contrôleurs : NodeController, ReplicaSetController, EndpointsController, ServiceAccountController...
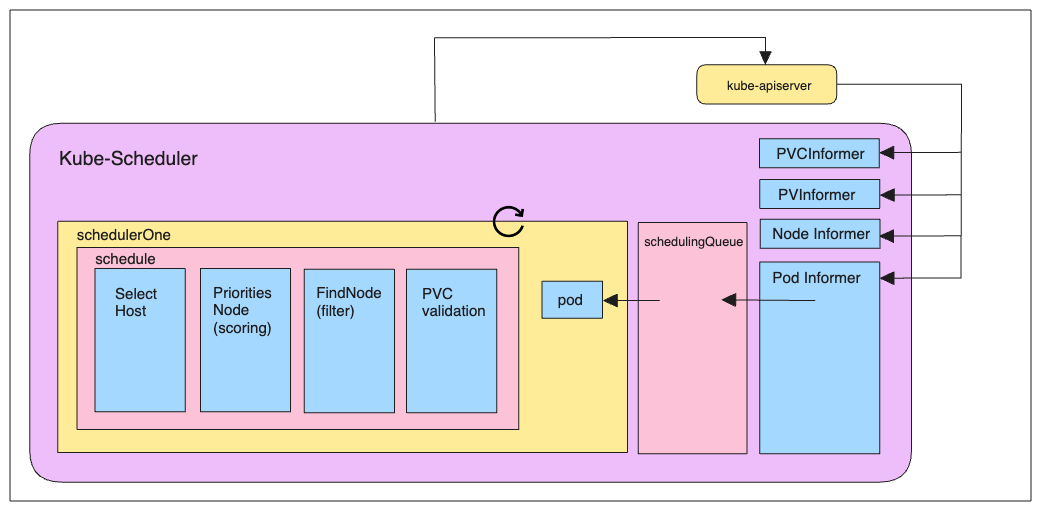
4. kube-scheduler : L'Aiguilleur Intelligent
Comment un Pod trouve-t-il son Node d'hébergement ?
[ Nouveau Pod non assigné (nodeName="") ]
               │
               ▼
      1. Filtrage (Predicates / Filtering)
      (Élimine les nœuds sans CPU/RAM, taints incompatibles...)
               │
               ▼
      2. Notation (Priorities / Scoring)
      (Classe les nœuds restants selon affinité, étalement des charges...)
               │
               ▼
[ Assignation au nœud avec le meilleur score ]
Les Composants du Worker Node
kubelet : L'agent de bord du nœud. Reçoit les ordres de l'APIServer, pilote le runtime conteneur et remonte la santé du nœud.
CRI (Container Runtime Interface) : Le moteur bas niveau (containerd, CRI-O) qui instancie les namespaces Linux et cgroups.
kube-proxy / eBPF : Configure le routage réseau local et le load balancing entre Pods.
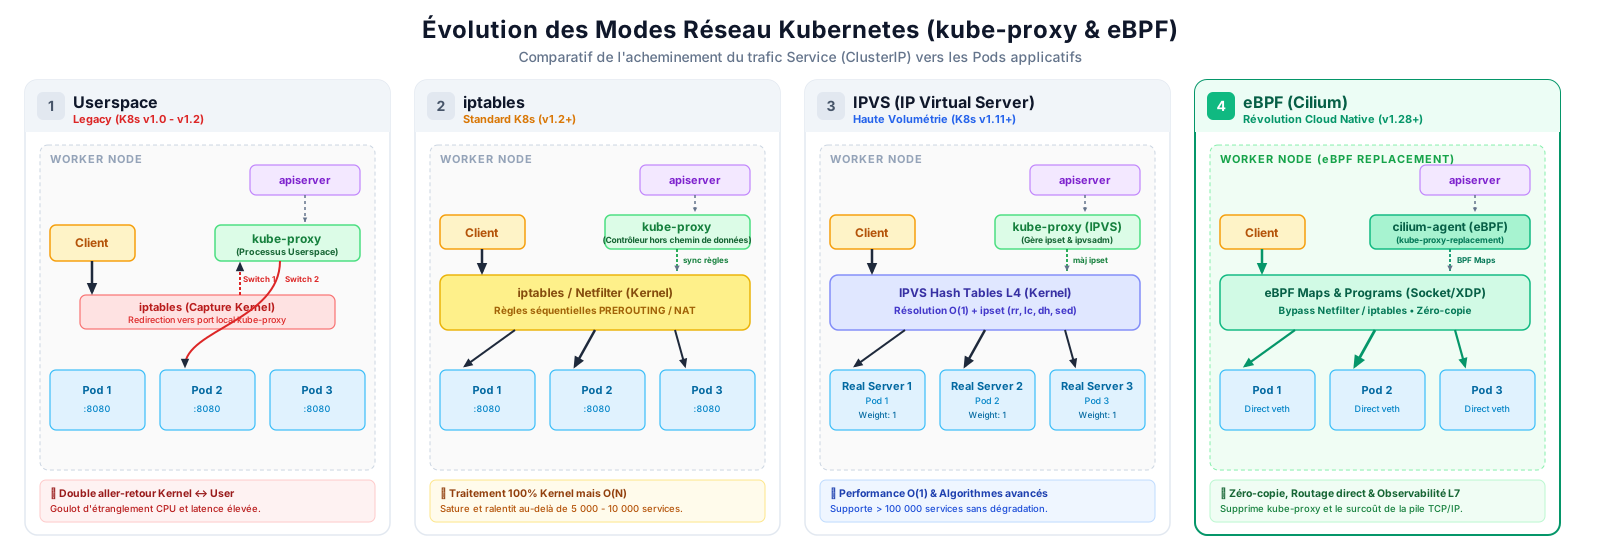
Les Modes Réseau : Du Legacy à l'eBPF
Userspace (historique) : Lent, passage constant entre kernel et user space.
iptables : Standard historique par règles de filtrage séquentielles (sature à partir de 10 000 services).
IPVS (IP Virtual Server) : Tables de hachage Linux, rapide et taillé pour la volumétrie.
eBPF (ex. Cilium) : Remplacement moderne de kube-proxy, routage directement dans le noyau sans surcoût iptables !
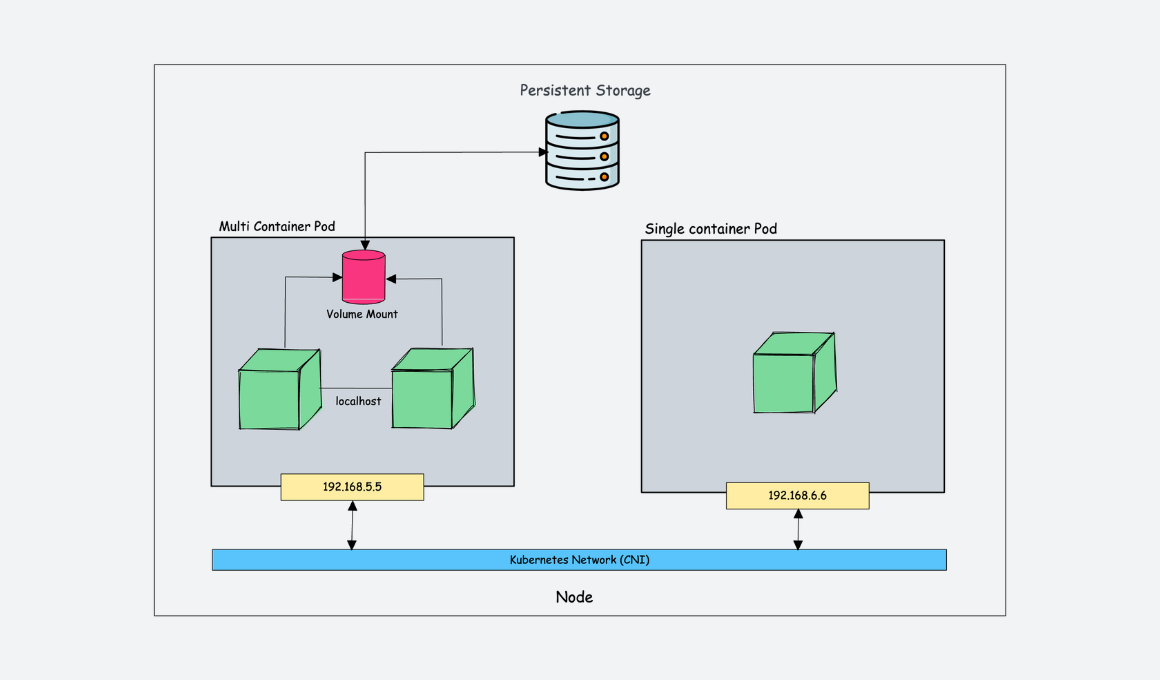
Le Modèle Réseau Fondamental
Kubernetes impose 3 règles absolues à tous les plugins réseau (CNI) :
Tous les Pods peuvent communiquer entre eux sans NAT.
Tous les Nodes peuvent communiquer avec tous les Pods sans NAT.
L'adresse IP qu'un Pod voit pour lui-même est exactement la même que celle vue par les autres.
Exemples de CNI majeurs : Cilium (eBPF & haute performance), Calico (politiques de sécurité BGP/IP-in-IP), Flannel (overlay simple).
Mini-Défi SRE : Autopsie de Pannes
Scénario 1 : Si le kube-apiserver devient inaccessible pendant 10 minutes, que deviennent les Pods applicatifs en cours d'exécution ?
Scénario 2 : Si le kube-scheduler crashe, que se passe-t-il lors d'un kubectl apply d'un nouveau Deployment ?
Mini-Défi SRE : Autopsie de Pannes (Réponses)
Scénario 1 : Si le kube-apiserver devient inaccessible pendant 10 minutes, que deviennent les Pods applicatifs en cours d'exécution ?
Réponse : Ils continuent de tourner normalement ! Seules les opérations de modification et le redémarrage en cas de crash sont gelés.
Scénario 2 : Si le kube-scheduler crashe, que se passe-t-il lors d'un kubectl apply d'un nouveau Deployment ?
Réponse : Le Deployment et les Pods sont créés dans etcd, mais les Pods restent bloqués en état Pending.
Contexte : Votre entreprise veut monter une chaîne CI/CD GitHub Actions pour tester le déploiement d'opérateurs K8s multi-nœuds à chaque Pull Request.
Question : Quelle solution privilégiez-vous ? 1. Un cluster EKS dédié allumé 24/7. 2. Un cluster local KinD instancié dynamiquement dans le runner de la CI. 3. Une VM avec Minikube.
Mini-Défi : Choix d'Architecture (Réponses)
Contexte : Votre entreprise veut monter une chaîne CI/CD GitHub Actions pour tester le déploiement d'opérateurs K8s multi-nœuds à chaque Pull Request.
Question : Quelle solution privilégiez-vous ? 1. Un cluster EKS dédié allumé 24/7. 2. Un cluster local KinD instancié dynamiquement dans le runner de la CI. 3. Une VM avec Minikube.
Réponse : Option 2 (KinD) ! Démarrage en ~20s, destruction automatique à la fin du job, coût quasi nul et isolation parfaite.
KUBERNETES : Piloter le Cluster avec kubectl & Kubeconfig
L'Arme Absolue de l'Ops : kubectl
CLI officiel pour interagir avec le kube-apiserver.
Transforme chaque commande en appel REST HTTPS sécurisé.
Lit par défaut sa configuration dans ~/.kube/config ou via $KUBECONFIG.
Au lieu de jongler manuellement avec des fichiers dispersés :
# 1. Fusionner plusieurs kubeconfigs en une seule vueexportKUBECONFIG=~/.kube/config:~/.kube/eks-prod:~/.kube/gke-dev
kubectl config view --flatten > ~/.kube/config.all
mv ~/.kube/config.all ~/.kube/config
# 2. Utiliser kubectx et kubens pour changer en 1 clickubectx prod-cluster
kubens billing-app
Explorer l'API : Ne Devinez Plus le YAML !
kubectl api-resources : Découvre toutes les ressources supportées (CRDs, versions, abréviations, portée namespace).
kubectl explain : La documentation intégrée directement dans votre terminal.
# Trouver la structure exacte d'un champkubectl explain pod.spec.containers.livenessProbe
# Explorer toute l'arborescencekubectl explain deployment.spec.strategy --recursive
Requêtes Expertes : Sortir des Tableaux Basiques
# 1. Vue enrichie immédiatekubectl get pods -o wide
# 2. Colonnes sur mesure (Custom Columns)kubectl get pods -o custom-columns=NAME:.metadata.name,IP:.status.podIP,NODE:.spec.nodeName
# 3. Tri avancé (ex: trier les pods par nombre de redémarrages)kubectl get pods --sort-by='.status.containerStatuses[0].restartCount'# 4. JSONPath chirurgical (extraire toutes les images utilisées)kubectl get pods -A -o jsonpath='{range .items[*]}{.spec.containers[*].image}{"\n"}{end}'|sort -u
Sélecteurs de Labels : Filtrer à l'Échelle
Ne cherchez jamais vos pods un par un :
# Ciblage par égalité ou ensemblekubectl get pods -l 'app=frontend,environment in (production, staging)'# Afficher les labels directement dans les colonneskubectl get pods -L app,version,tier
L'Écosystème des Plugins krew
krew est le gestionnaire de paquets officiel pour étendre kubectl :
kubectl krew install ctx ns neat who-can tree
# kubectl-tree : Visualise toute la hiérarchie d'objets créés par un Deploymentkubectl tree deploy web-app
# kubectl-who-can : Qui a le droit de supprimer des namespaces ?kubectl who-can delete namespaces
Mini-Défi : La Commande Ninja
Objectif : Vous suspectez une fuite de mémoire sur un cluster de 150 pods.
Quelle commande en une ligne permet de lister le nom de tous les pods ayant déjà redémarré au moins 1 fois, triés par leur nœud ?
Mini-Défi : La Commande Ninja
Objectif : Vous suspectez une fuite de mémoire sur un cluster de 150 pods.
Quelle commande en une ligne permet de lister le nom de tous les pods ayant déjà redémarré au moins 1 fois, triés par leur nœud ?
[ Fichier Local (Nouveau souhait) ]
               │
               ▼
[ Last-Applied-Configuration (Annotation dans l'objet) ]
               │
               ▼
[ État Actuel en Direct dans etcd ]
Cela permet de fusionner vos changements sans écraser les champs injectés dynamiquement (ex: annotations de monitoring, tokens de sécurité ou IP de statut).
Détecter les Dérives : kubectl diff
Avant d'appliquer une modification en production :
# Affiche le diff exact entre le cluster et vos fichiers locaux (couleurs git diff)kubectl diff -f k8s/production/
# Appliquer avec Server-Side Apply (standard moderne K8s 1.22+)kubectl apply --server-side -f k8s/production/
Mini-Défi : Le « Speedrun » YAML
Objectif : En moins de 30 secondes et sans ouvrir d'éditeur de texte, générez un fichier stack.yaml contenant à la fois un Deploymentredis (image redis:alpine) et son Serviceredis-svc exposant le port TCP 6379.
Mini-Défi : Le « Speedrun » YAML
Objectif : En moins de 30 secondes et sans ouvrir d'éditeur de texte, générez un fichier stack.yaml contenant à la fois un Deploymentredis (image redis:alpine) et son Serviceredis-svc exposant le port TCP 6379.
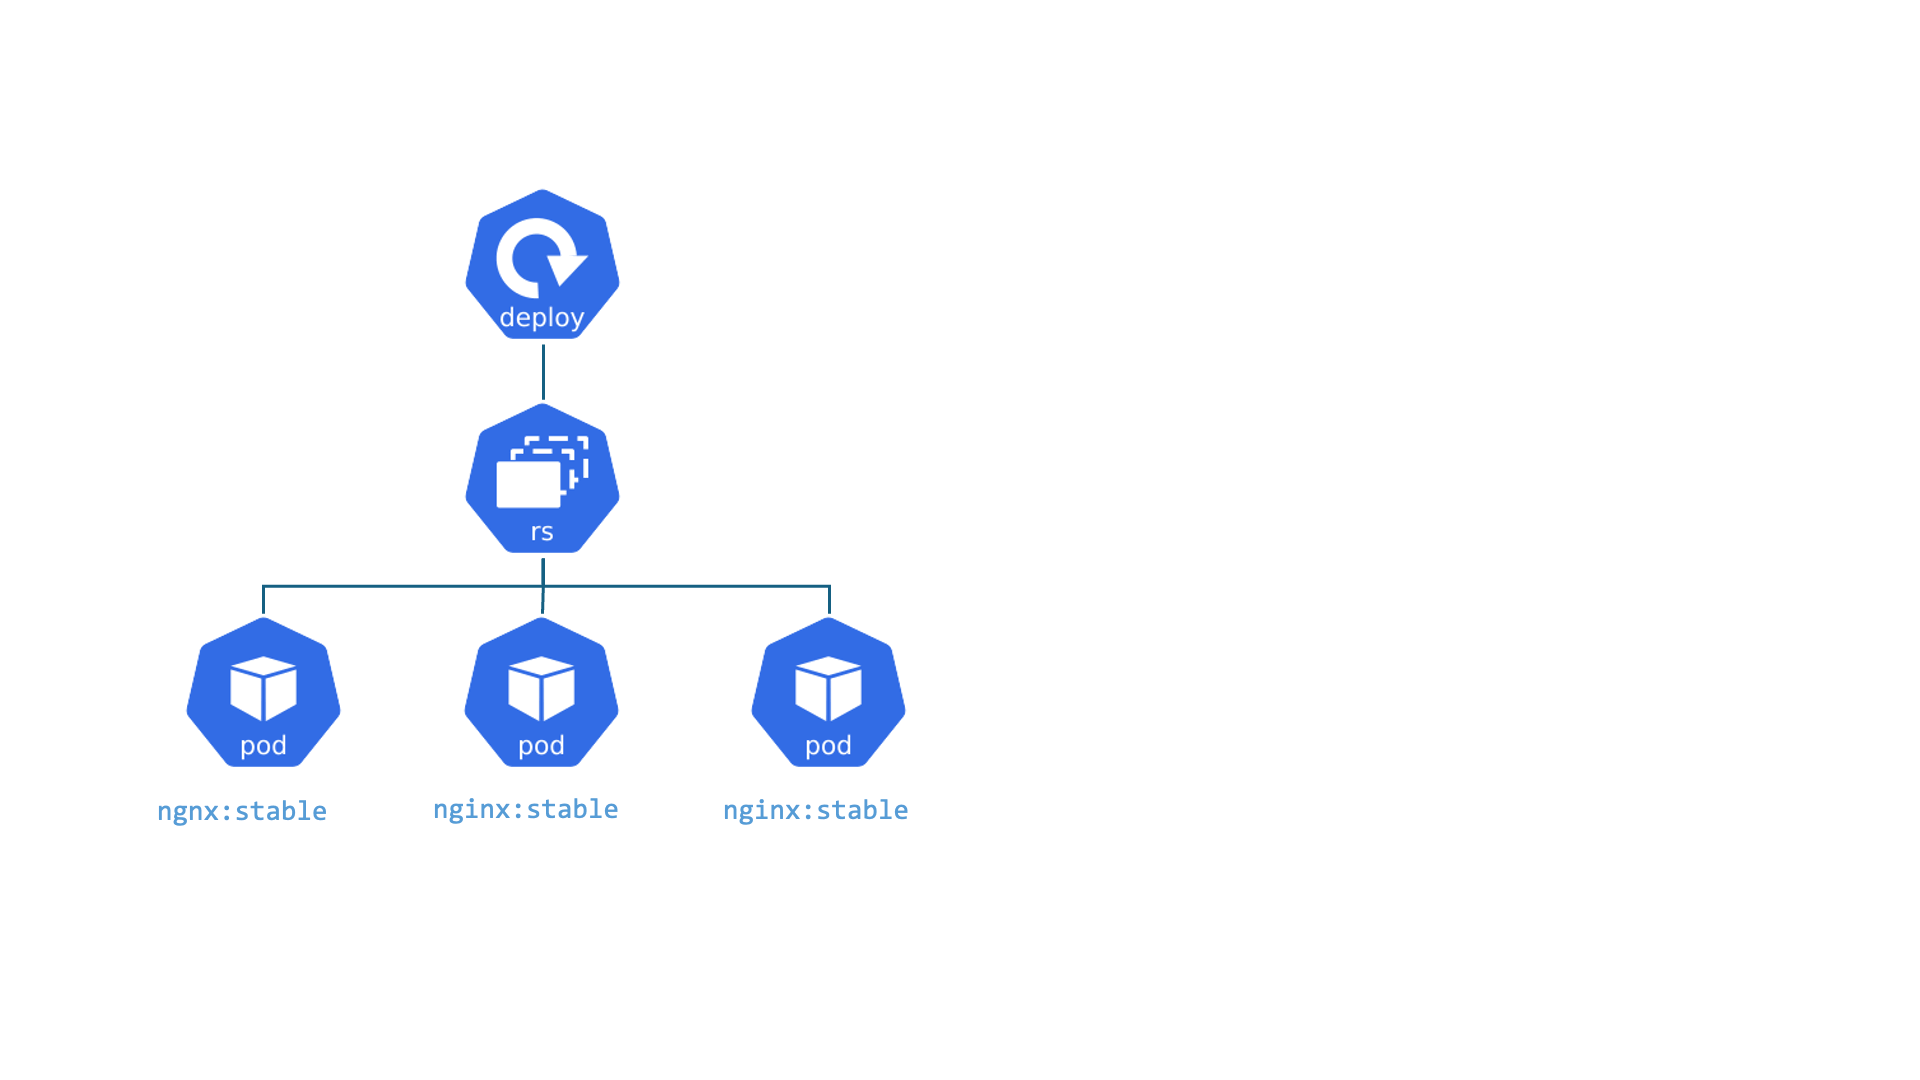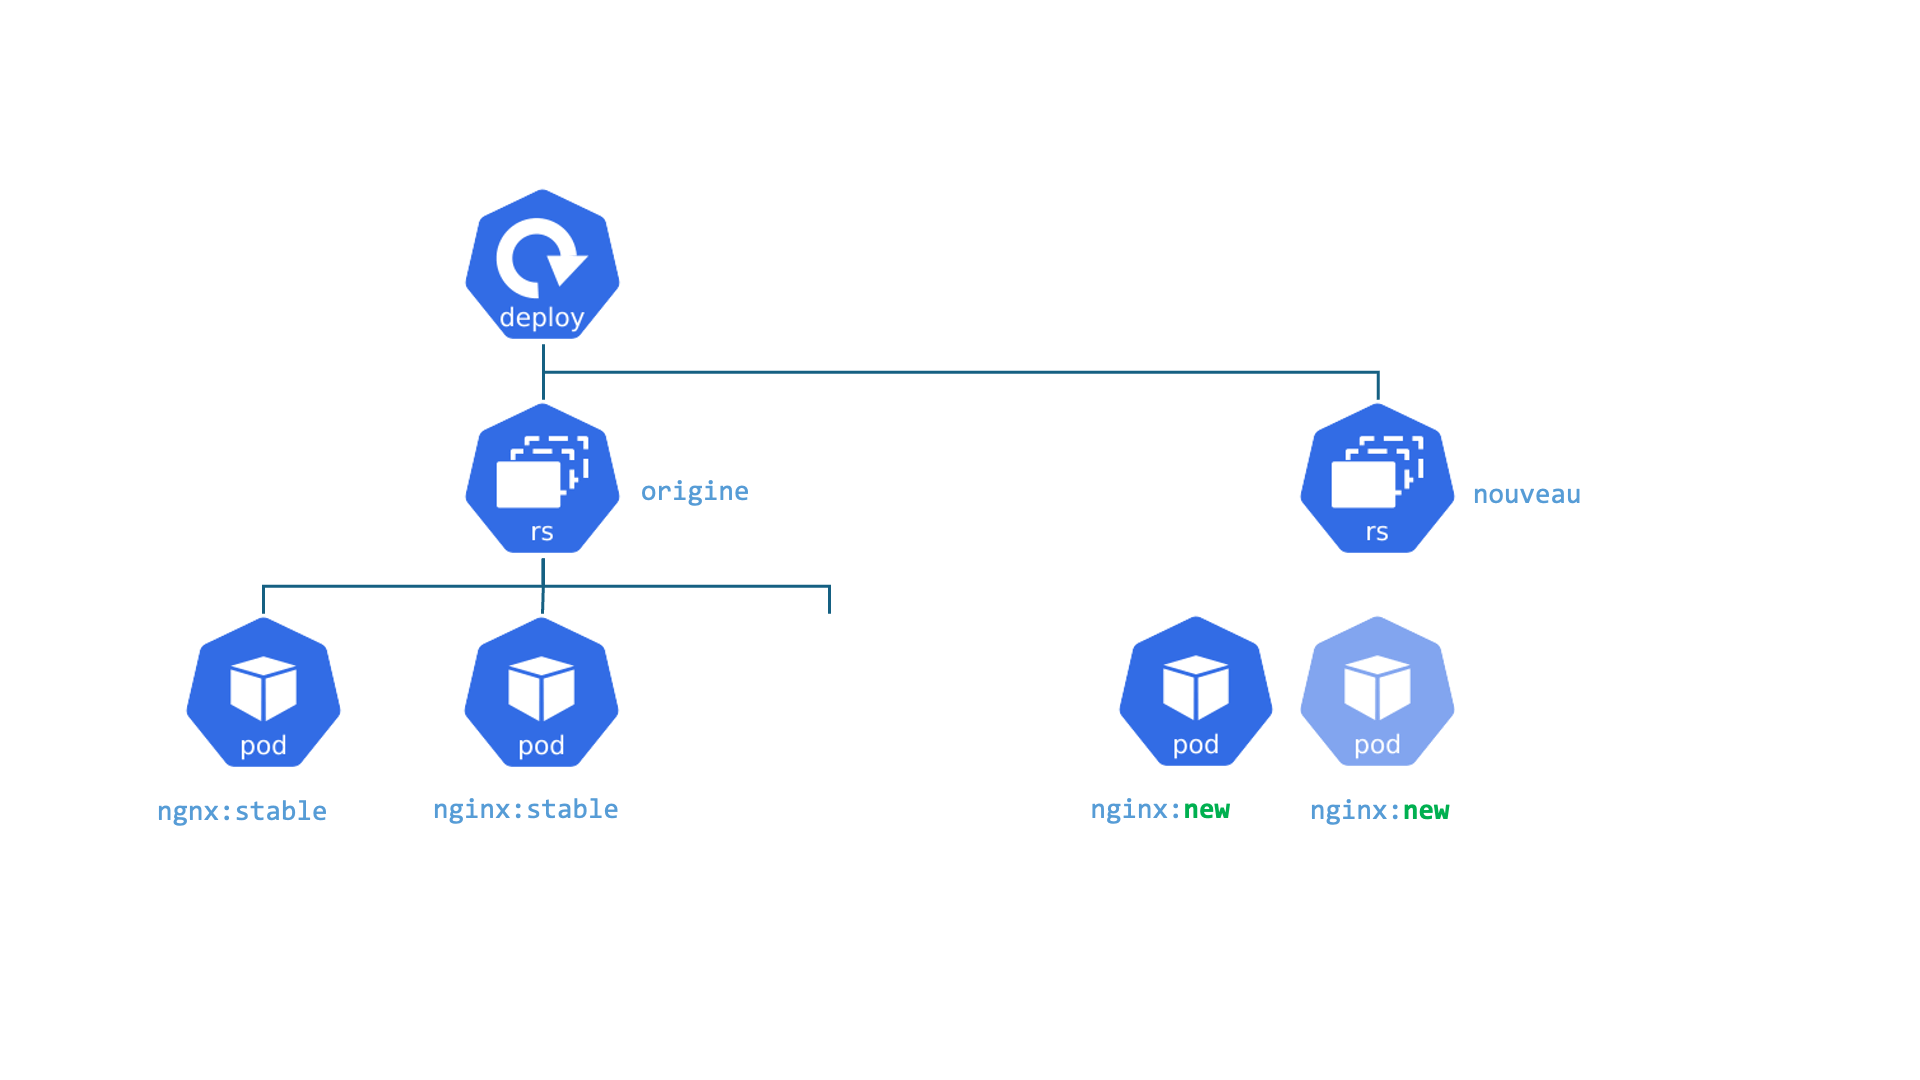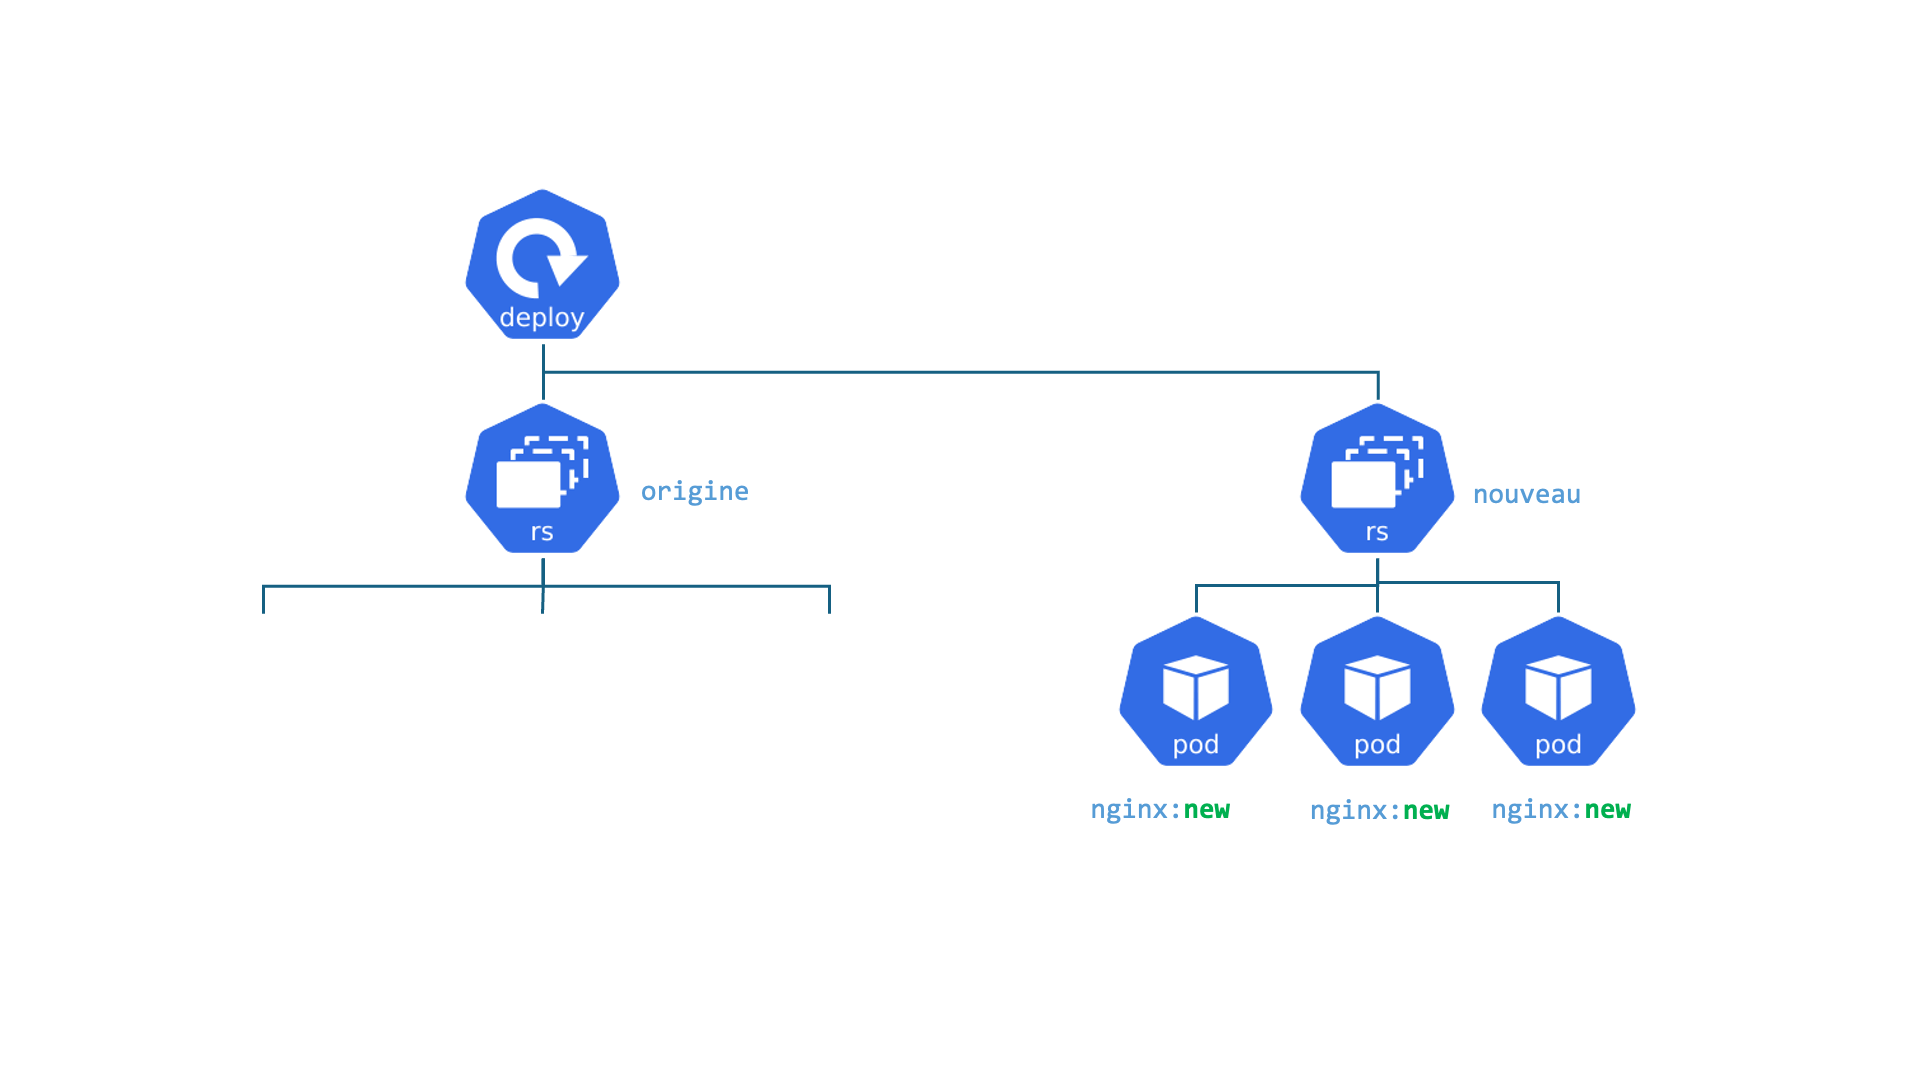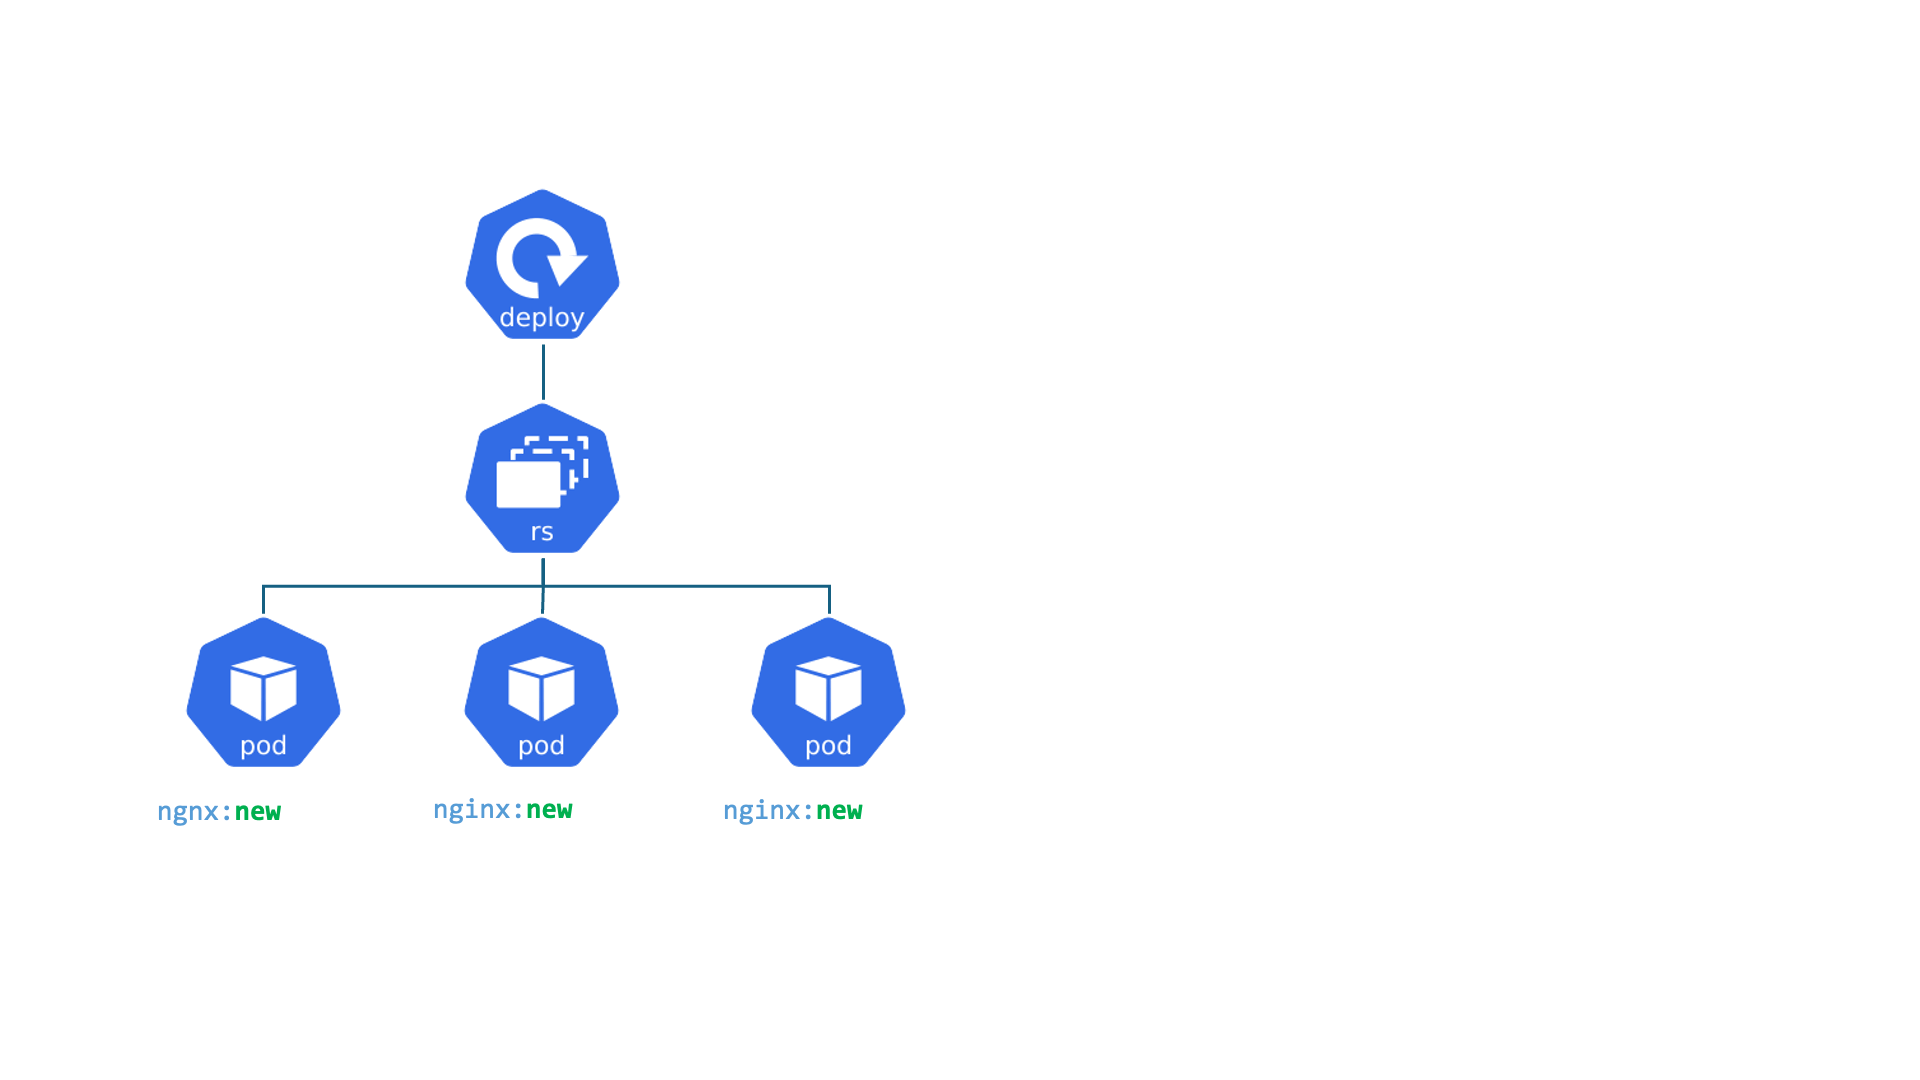
spec:replicas: 5strategy:type: RollingUpdaterollingUpdate:maxSurge: 1 # Max 1 pod en plus pendant le déploiement (total 6)maxUnavailable: 0 # 0 interruption tolérée : aucun pod détruit avant qu'un nouveau soit Ready
# Surveiller en direct le déploiementkubectl rollout status deployment/web-app
# Revenir en arrière en cas de bug en 1 seconde !kubectl rollout undo deployment/web-app
4. StatefulSet : Pour les Données & l'Ordre Strict
Quand vos applications ne sont pas jetables (bases de données, Kafka, ElasticSearch, postgress, mongo, redis, etc) :
Création ordonnée : Le pod 1 démarre uniquement quand le pod 0 est Ready.
Persistance garantie : Si un pod meurt, son remplaçant récupère exactement le même disque !
5. DaemonSet, Job & CronJob
Objet
Rôle Principal
Cas d'Usage Typique
DaemonSet
Exécute exactement 1 copie du Pod sur chaque nœud
Collecteur de logs (Fluentd), agent de métriques (Prometheus node-exporter), CNI
Job
Exécute une tâche jusqu'à son terme (succès) puis s'arrête
Migration de schéma SQL, calcul de rapport ponctuel
CronJob
Planifie des Jobs selon une expression temporelle cron
Sauvegarde nocturne 0 2 * * *, nettoyage de logs
5. DaemonSet, Job & CronJob (Suite)
apiVersion: batch/v1kind: CronJobmetadata:name: db-backupspec:schedule:"0 3 * * *" # Tous les jours à 3h du matinjobTemplate:spec:template:spec:containers:-name: pg-dumpimage: postgres:16-alpinerestartPolicy: OnFailure
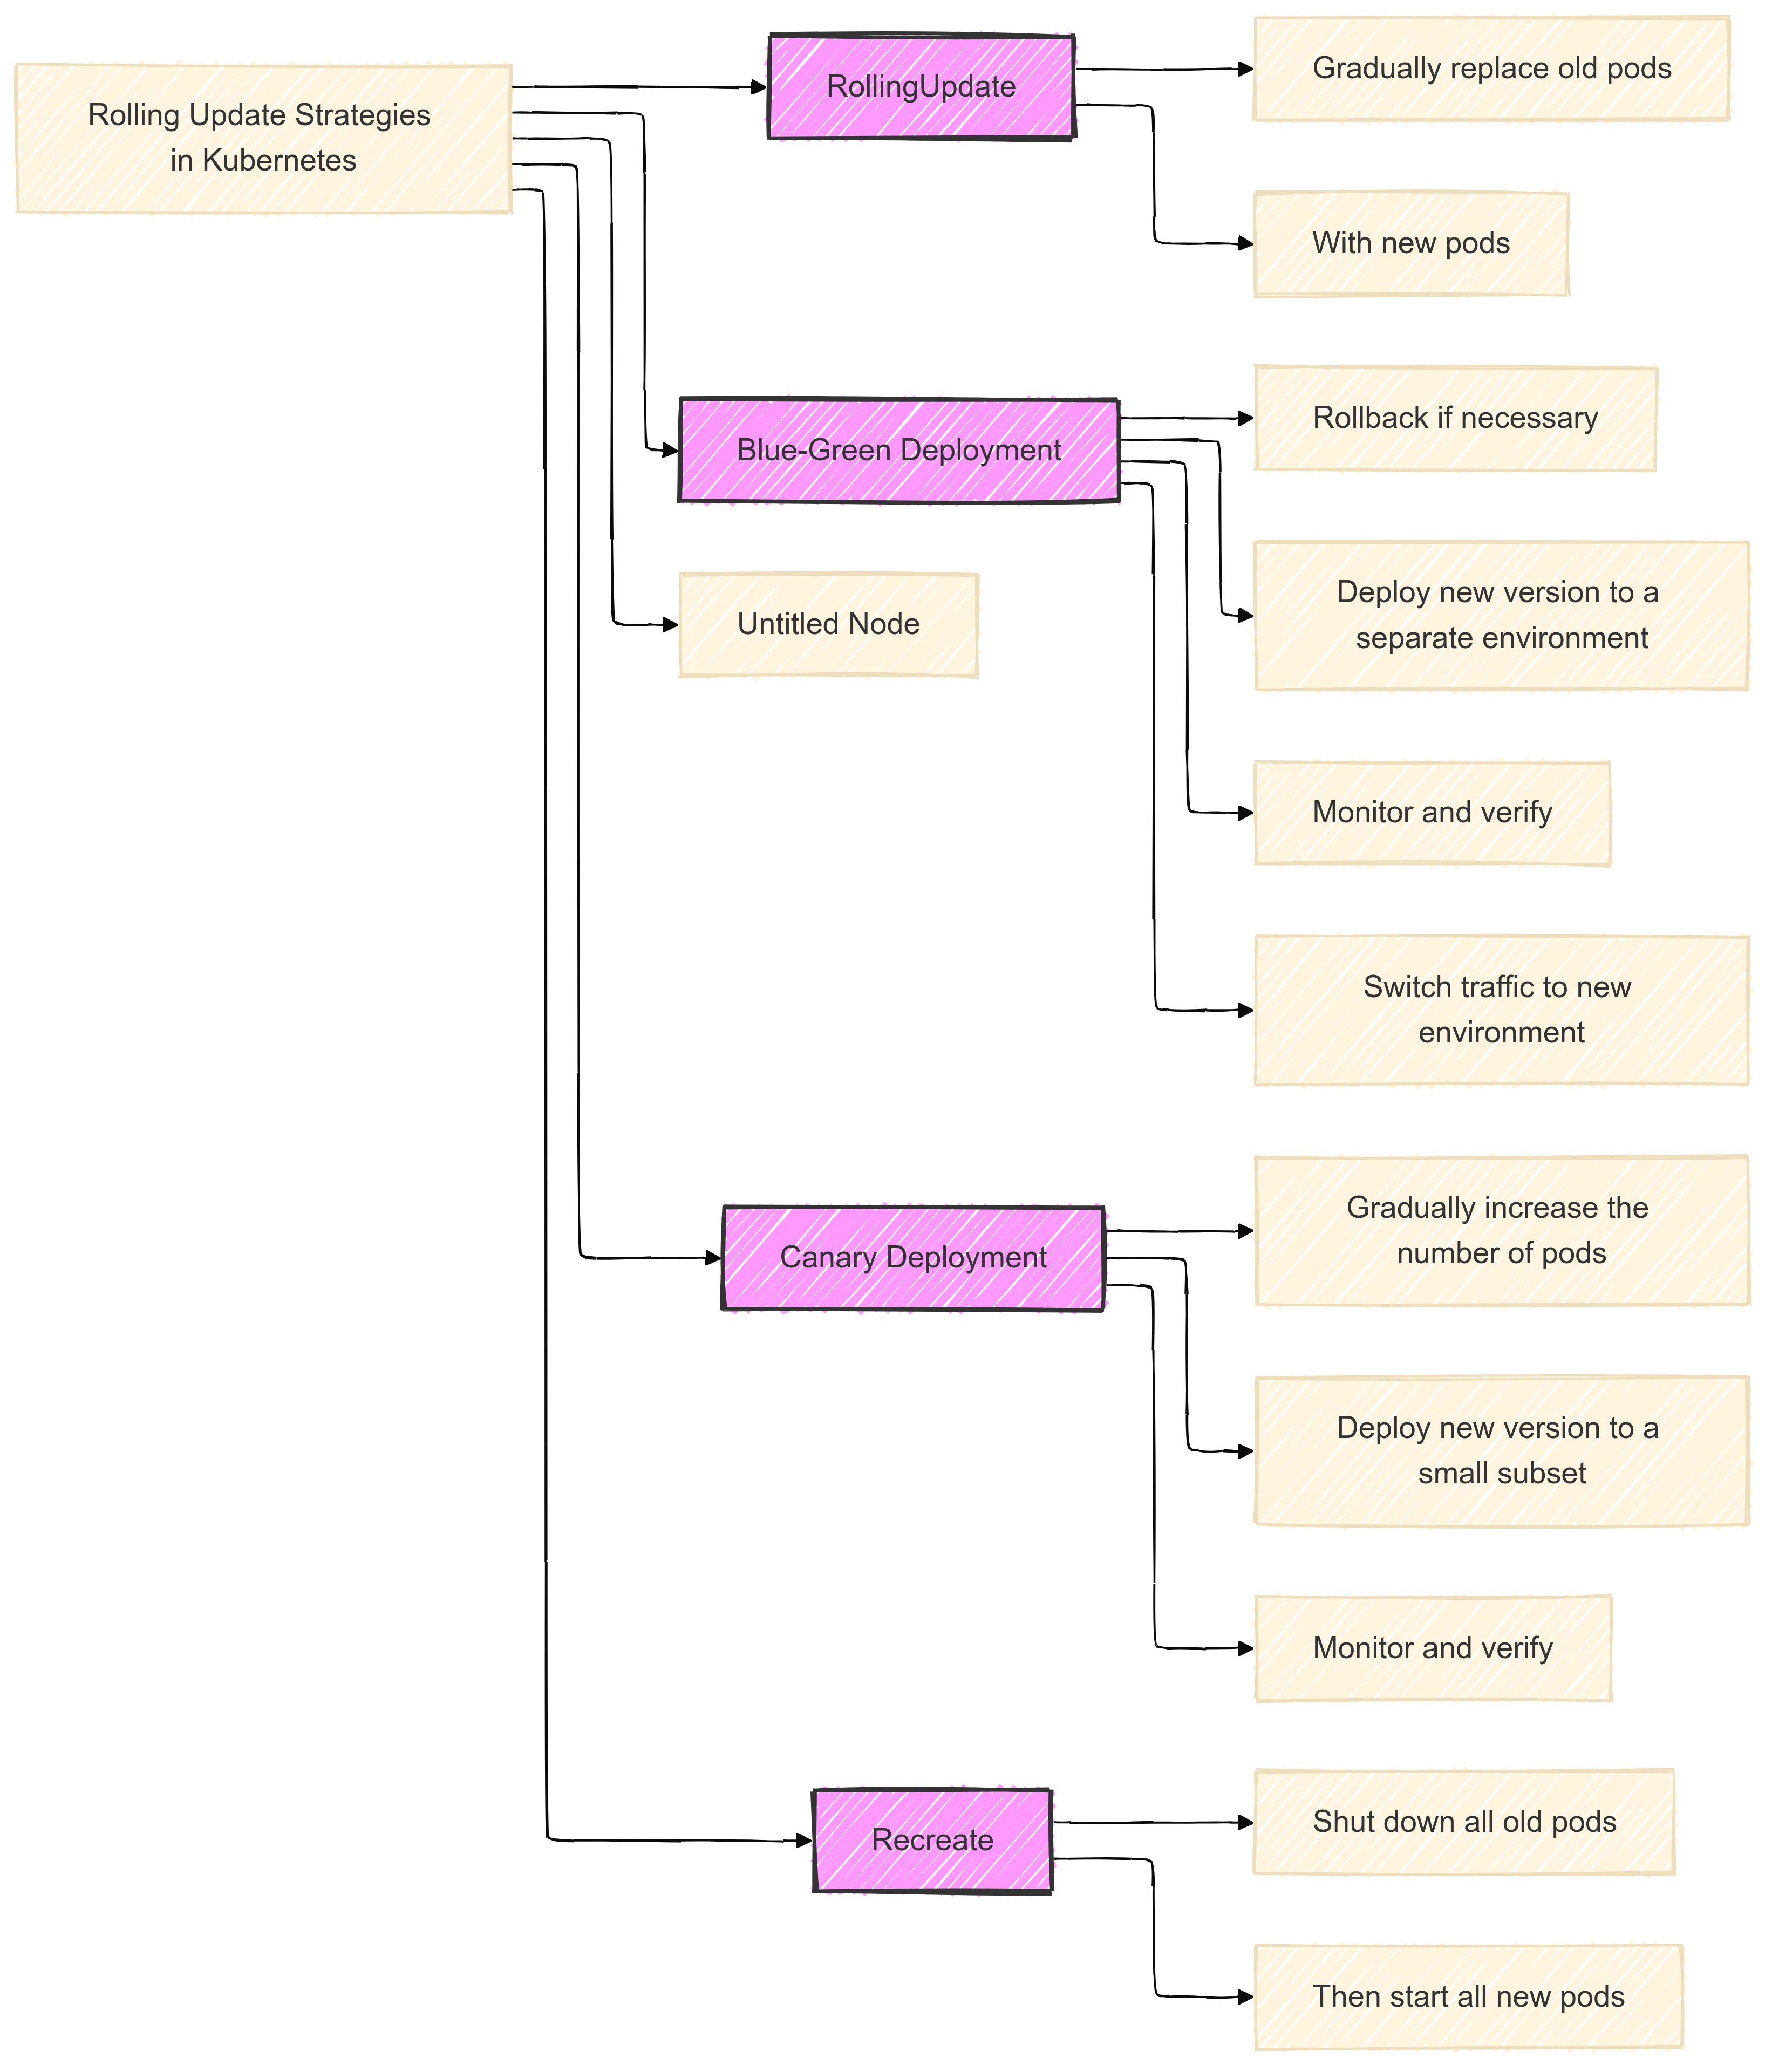
6. Strategies de rolling Update
Mini-Défi : Le « Piège du Sélecteur »
Code Review : Pourquoi le Service ci-dessous ne reçoit aucun trafic bien que les 3 Pods du Deployment soient Running ?
# Deploymentspec:template:metadata:labels:app: backend-apitier: core---# Servicespec:selector:app: backend-apitier: api
Mini-Défi : Le « Piège du Sélecteur »
Code Review : Pourquoi le Service ci-dessous ne reçoit aucun trafic bien que les 3 Pods du Deployment soient Running ?
# Deploymentspec:template:metadata:labels:app: backend-apitier: core---# Servicespec:selector:app: backend-apitier: api
Réponse : Le sélecteur du Service exige tier: api, alors que les Pods ont tier: core. Les labels doivent correspondre exactement !.
KUBERNETES : Configuration & Secrets des Applications
Le Principe 12-Factor : Découpler Code & Configuration
Une même image binaire doit pouvoir tourner en Dev, Pré-prod et Prod sans être recompilée.
Les données non sensibles vont dans ConfigMap, les secrets d'accès dans Secret.
1. ConfigMaps : Deux Modes d'Injection
apiVersion: v1kind: Podmetadata:name: app-config-demospec:containers:-name: appimage: my-app:1.0# Mode A : Injecté comme Variable d'Environnementenv:-name: DATABASE_URLvalueFrom:configMapKeyRef:name: app-configkey: db_url# Mode B : Monté comme Fichier de ConfigurationvolumeMounts:-name: config-volumemountPath: /etc/app/config.jsonsubPath: config.json # <── Ne masque pas les autres fichiers du dossier !volumes:-name: config-volumeconfigMap:name: app-config
Injection Globale : envFrom
Pour injecter 50 variables d'un seul coup sans les déclarer une par une :
2. Secrets Kubernetes : Attention aux Fausses Idées !
Alerte Sécurité : Les Secrets Kubernetes natifs sont simplement encodés en Base64, ils ne sont PAS chiffrés par défaut dans etcd si l'EncryptionConfiguration n'est pas activée !
# Encoder une valeurecho -n "SuperSecretPass123"|base64# -> U3VwZXJTZWNyZXRQYXNzMTIz# Décoderecho"U3VwZXJTZWNyZXRQYXNzMTIz"|base64 -d
Types de Secrets natifs :
Opaque : Clés/Valeurs personnalisées (mots de passe, tokens API).
kubernetes.io/tls : Certificat (tls.crt) et clé privée (tls.key).
kubernetes.io/dockerconfigjson : Identifiants de registre privé d'images (imagePullSecrets).
Gestion Industrielle des Secrets (GitOps Ready)
Dans une démarche GitOps, interdiction de commiter des Secrets K8s en clair dans Git !
Sealed Secrets (Bitnami) : Chiffrement asymétrique. Seul le cluster K8s possède la clé privée pour déchiffrer le manifeste commit dans Git.
External Secrets Operator (ESO) : Synchronise les secrets directement depuis HashiCorp Vault, AWS Secrets Manager, GCP Secret Manager ou Azure Key Vault.
# 1. Déclaration du SecretStore (Connexion à Vault)apiVersion: external-secrets.io/v1beta1kind: SecretStoremetadata:name: vault-storespec:provider:vault:server:"https://vault.my-company.com"path:"kv"auth:kubernetes:role:"k8s-role"# 2. Déclaration du ExternalSecretapiVersion: external-secrets.io/v1beta1kind: ExternalSecretmetadata:name: external-db-secretspec:secretStoreRef:name: vault-storekind: SecretStoretarget:name: db-secret-from-vault # Le nom du Secret K8s qui va être créédata:-secretKey: passwordremoteRef:key: my-org/prod/databaseproperty: DB_PASSWORD
Mini-Défi : Le Mystère de la Variable Fantôme
Incident SRE : Vous modifiez une valeur dans un ConfigMap existant via kubectl edit cm app-config.
Réponse : Les variables d'environnement (env / envFrom) sont injectées au moment du démarrage du processus dans le conteneur. Elles ne se mettent pas à jour à chaud ! Il faut redémarrer le Pod (kubectl rollout restart deployment/mon-app) ou monter le ConfigMap en tant que Volume.
Requests : Ce que le kube-scheduler réserve pour décider sur quel nœud placer le Pod.
Limits : Le plafond absolu imposé par le noyau Linux (cgroups v2) au runtime.
CPU vs RAM : Deux Comportements Radicaux
Ressource
Nature
Comportement en cas de Dépassement
Unité
CPU
Compressible
CPU Throttling : Le processus est bridé en temps CPU (latence p99 explose, mais le pod reste vivant).
Millicores (500m = 0.5 vCPU)
Mémoire (RAM)
Incompressible
OOMKilled (Code 137) : Le Kernel Linux tue instantanément le conteneur via un SIGKILL.
Mébibytes (256Mi, 1Gi)
Un mébibyte (MiB ) est également une unité d'information numérique, mais il est basé sur le système binaire. Un mébibyte équivaut à 1024 x 1024 octets = 1 048 576 octets, soit 2^20 octets. Le terme "mébibyte" a été introduit par la Commission électrotechnique internationale (CEI) en 1998 pour établir une distinction claire avec le mégaoctet basé sur le système décimal. Malheureusement, le terme mébibyte n'a pas encore été adopté par le grand public, de sorte que vous verrez régulièrement "mégaoctet" ou simplement MB, se référant soit à 1 000 000 d'octets, soit à 1 048 576 octets, sans savoir lequel est le bon.
Kubernetes classe automatiquement chaque Pod pour savoir qui sacrifier en premier en cas de saturation d'un nœud :
1. Guaranteed (Protégé) ──► requests == limits (CPU et RAM) pour tous les conteneurs
2. Burstable (Standard) ──► Au moins 1 request définie, requests < limits
3. BestEffort (Sacrifié) ──► Aucune request ni limit définie
En cas de pénurie de mémoire sur un Worker Node, le Kubelet évince et détruit en priorité les Pods BestEffort, puis Burstable, et enfin Guaranteed en tout dernier recours.
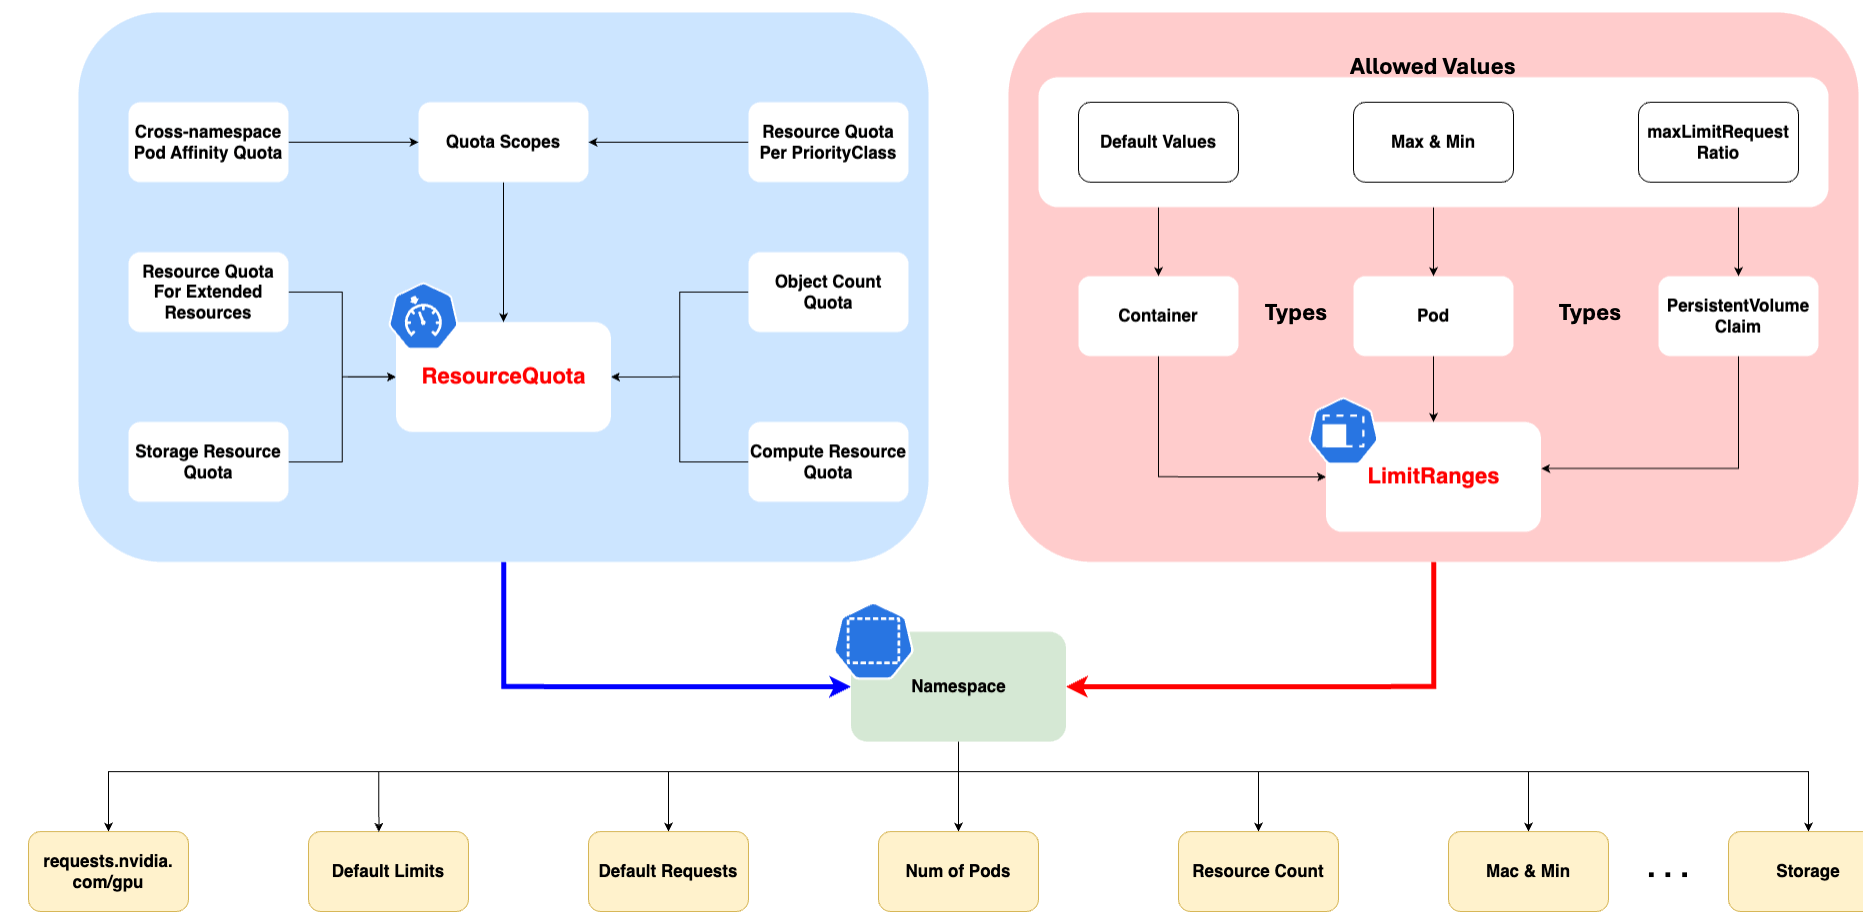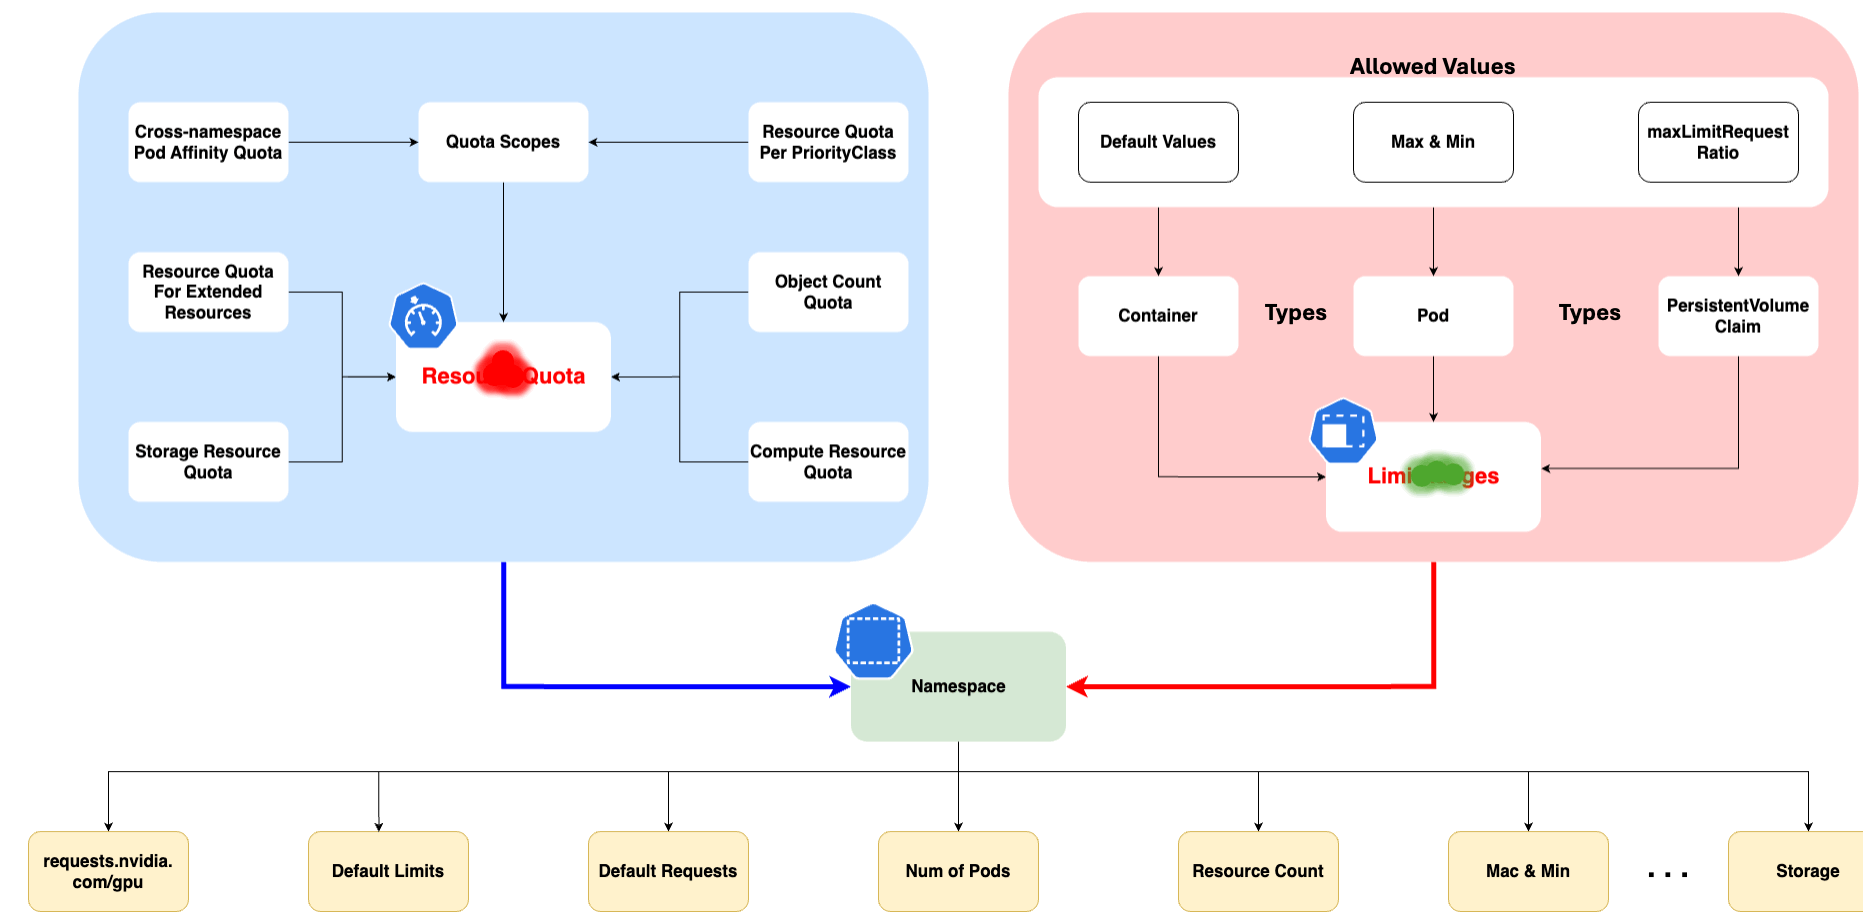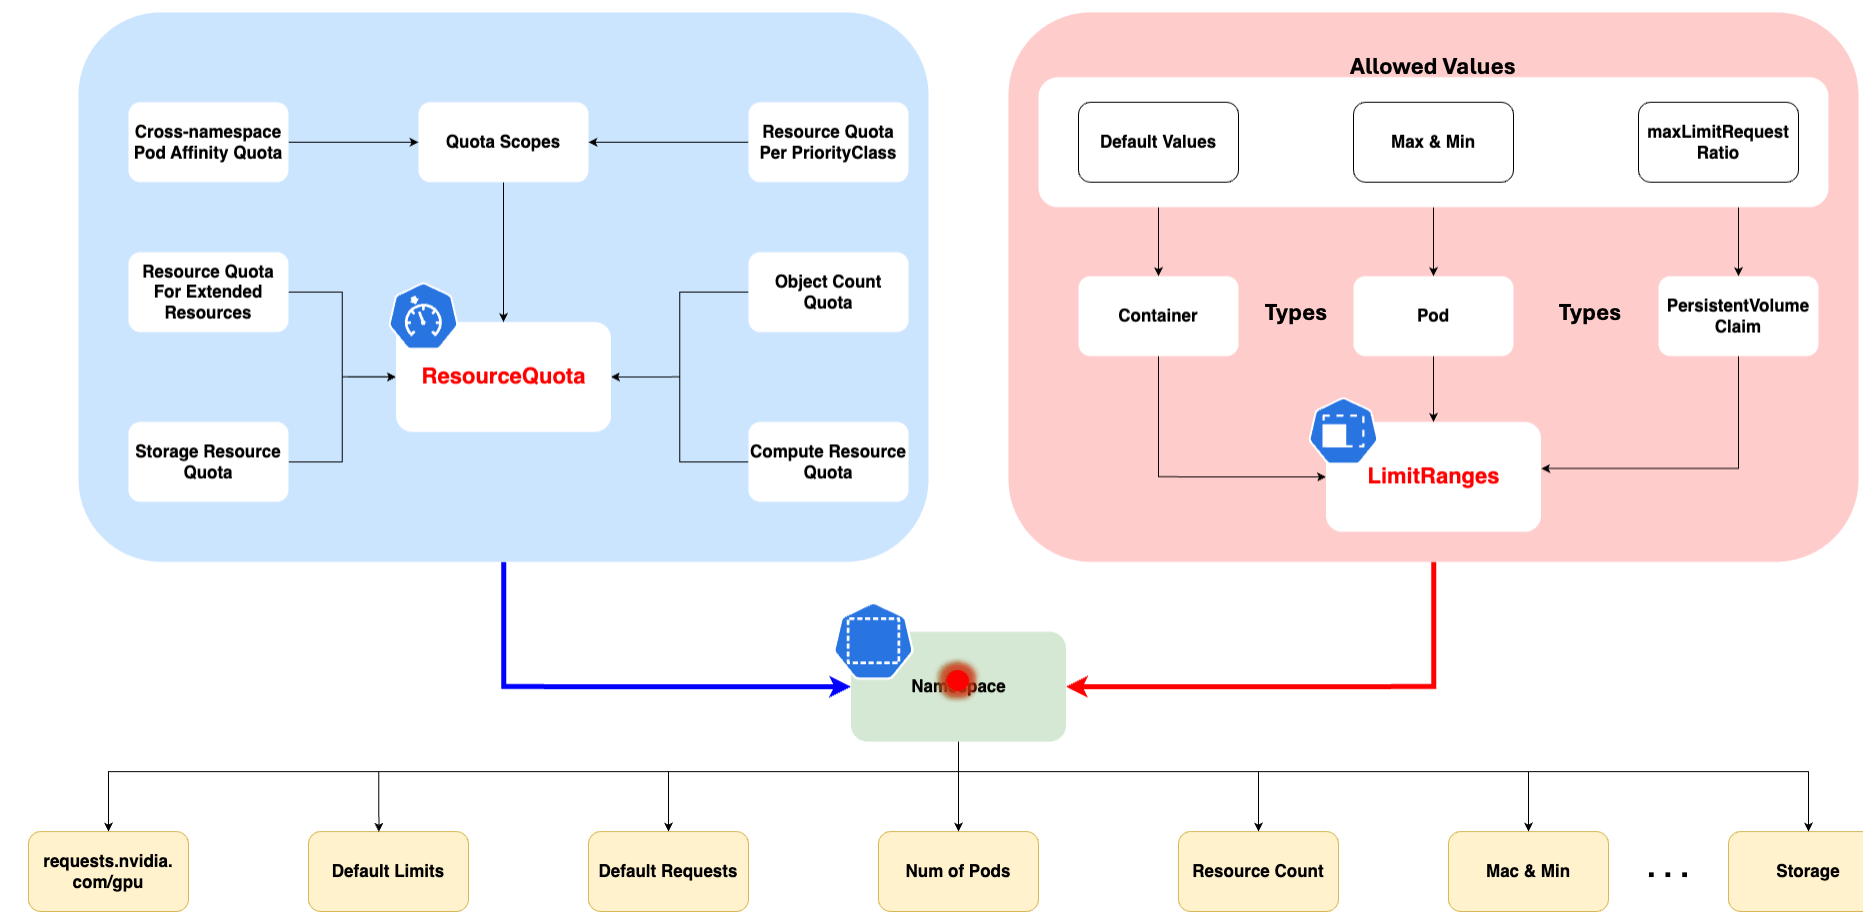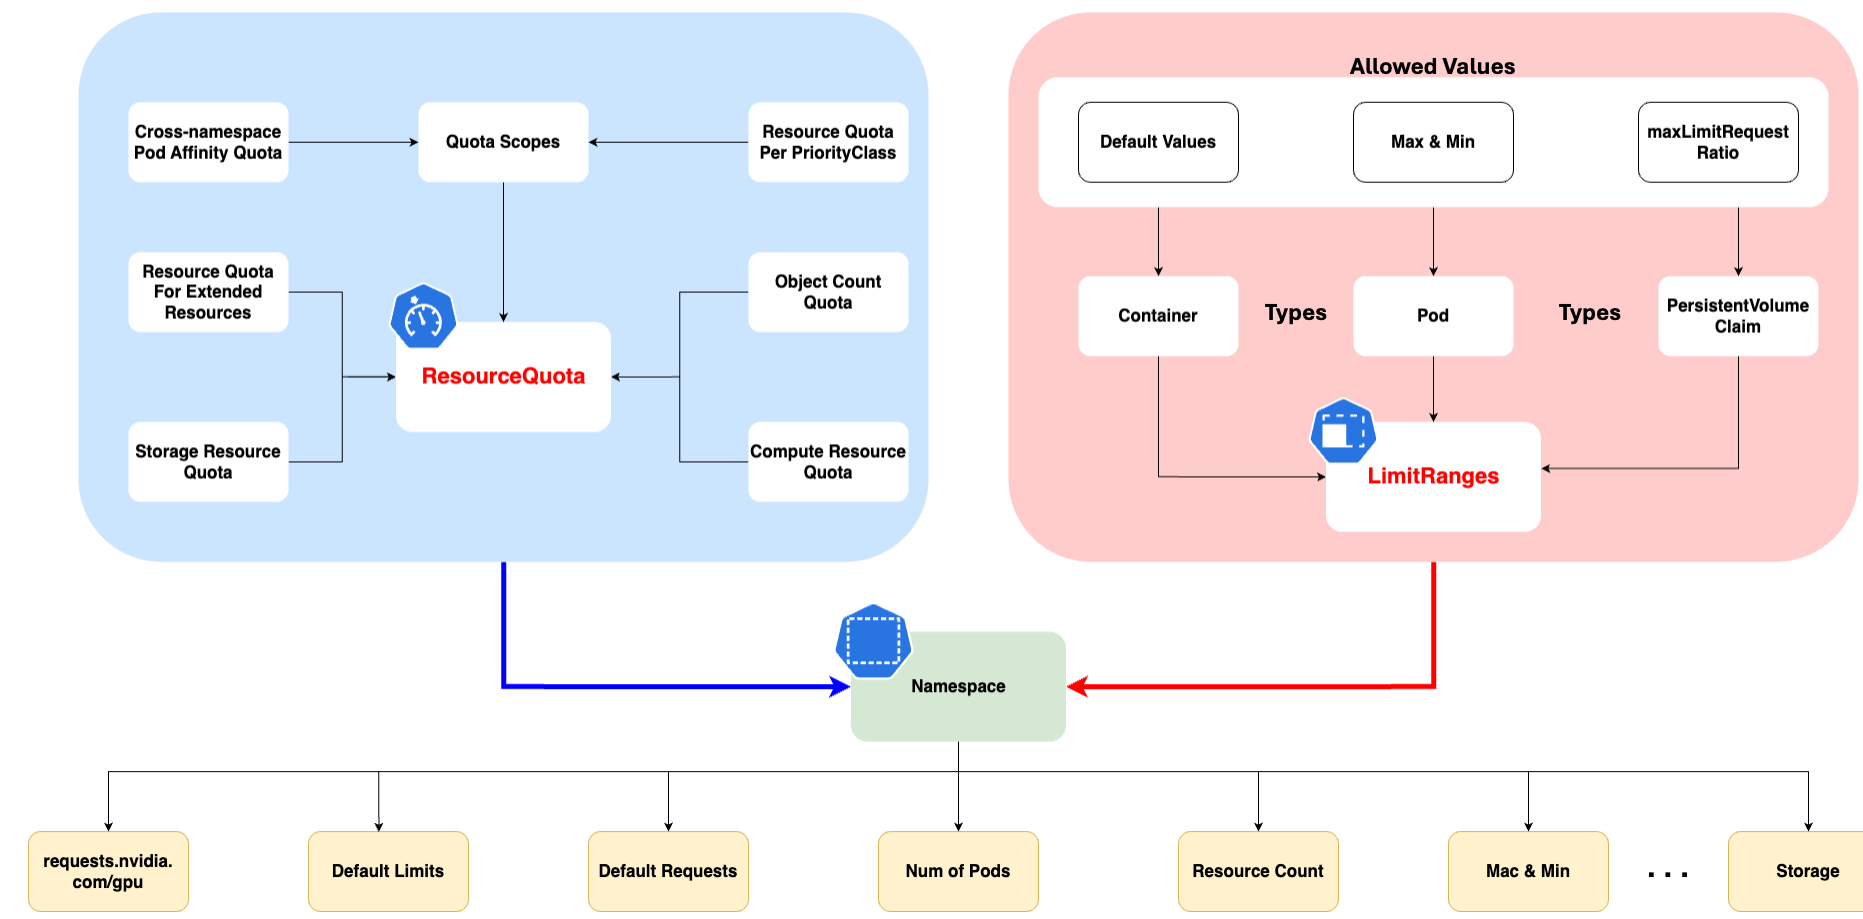
Gouvernance : LimitRange vs ResourceQuota
         LIMITRANGE                             RESOURCEQUOTA
  (S'applique à CHAQUE Pod)             (S'applique à TOUT le Namespace)
             │                                         │
             ▼                                         ▼
Injecte des requests par défaut         Plafonne la consommation totale
et empêche les pods démesurés           (ex: Max 32 vCPU et 64GiB au total)
Scénario d'incident : Vous déployez un pod avec requests.cpu: "4".
En regardant avec htop sur le Worker Node, le CPU réel consommé n'est que de 10%. Pourtant, le Pod reste bloqué en statut Pending. Pourquoi ?
Mini-Défi : Le Mystère du Pod Pending
Scénario d'incident : Vous déployez un pod avec requests.cpu: "4".
En regardant avec htop sur le Worker Node, le CPU réel consommé n'est que de 10%. Pourtant, le Pod reste bloqué en statut Pending. Pourquoi ?
Réponse : Le scheduler prend ses décisions sur la base de la somme des Requests réservées, et non sur la charge réelle du CPU à l'instant T ! Si les autres pods ont réservé tout le CPU théorique du nœud, le scheduler refuse d'en ajouter un nouveau.
KUBERNETES : Ordonnancement & Stratégies de Placement
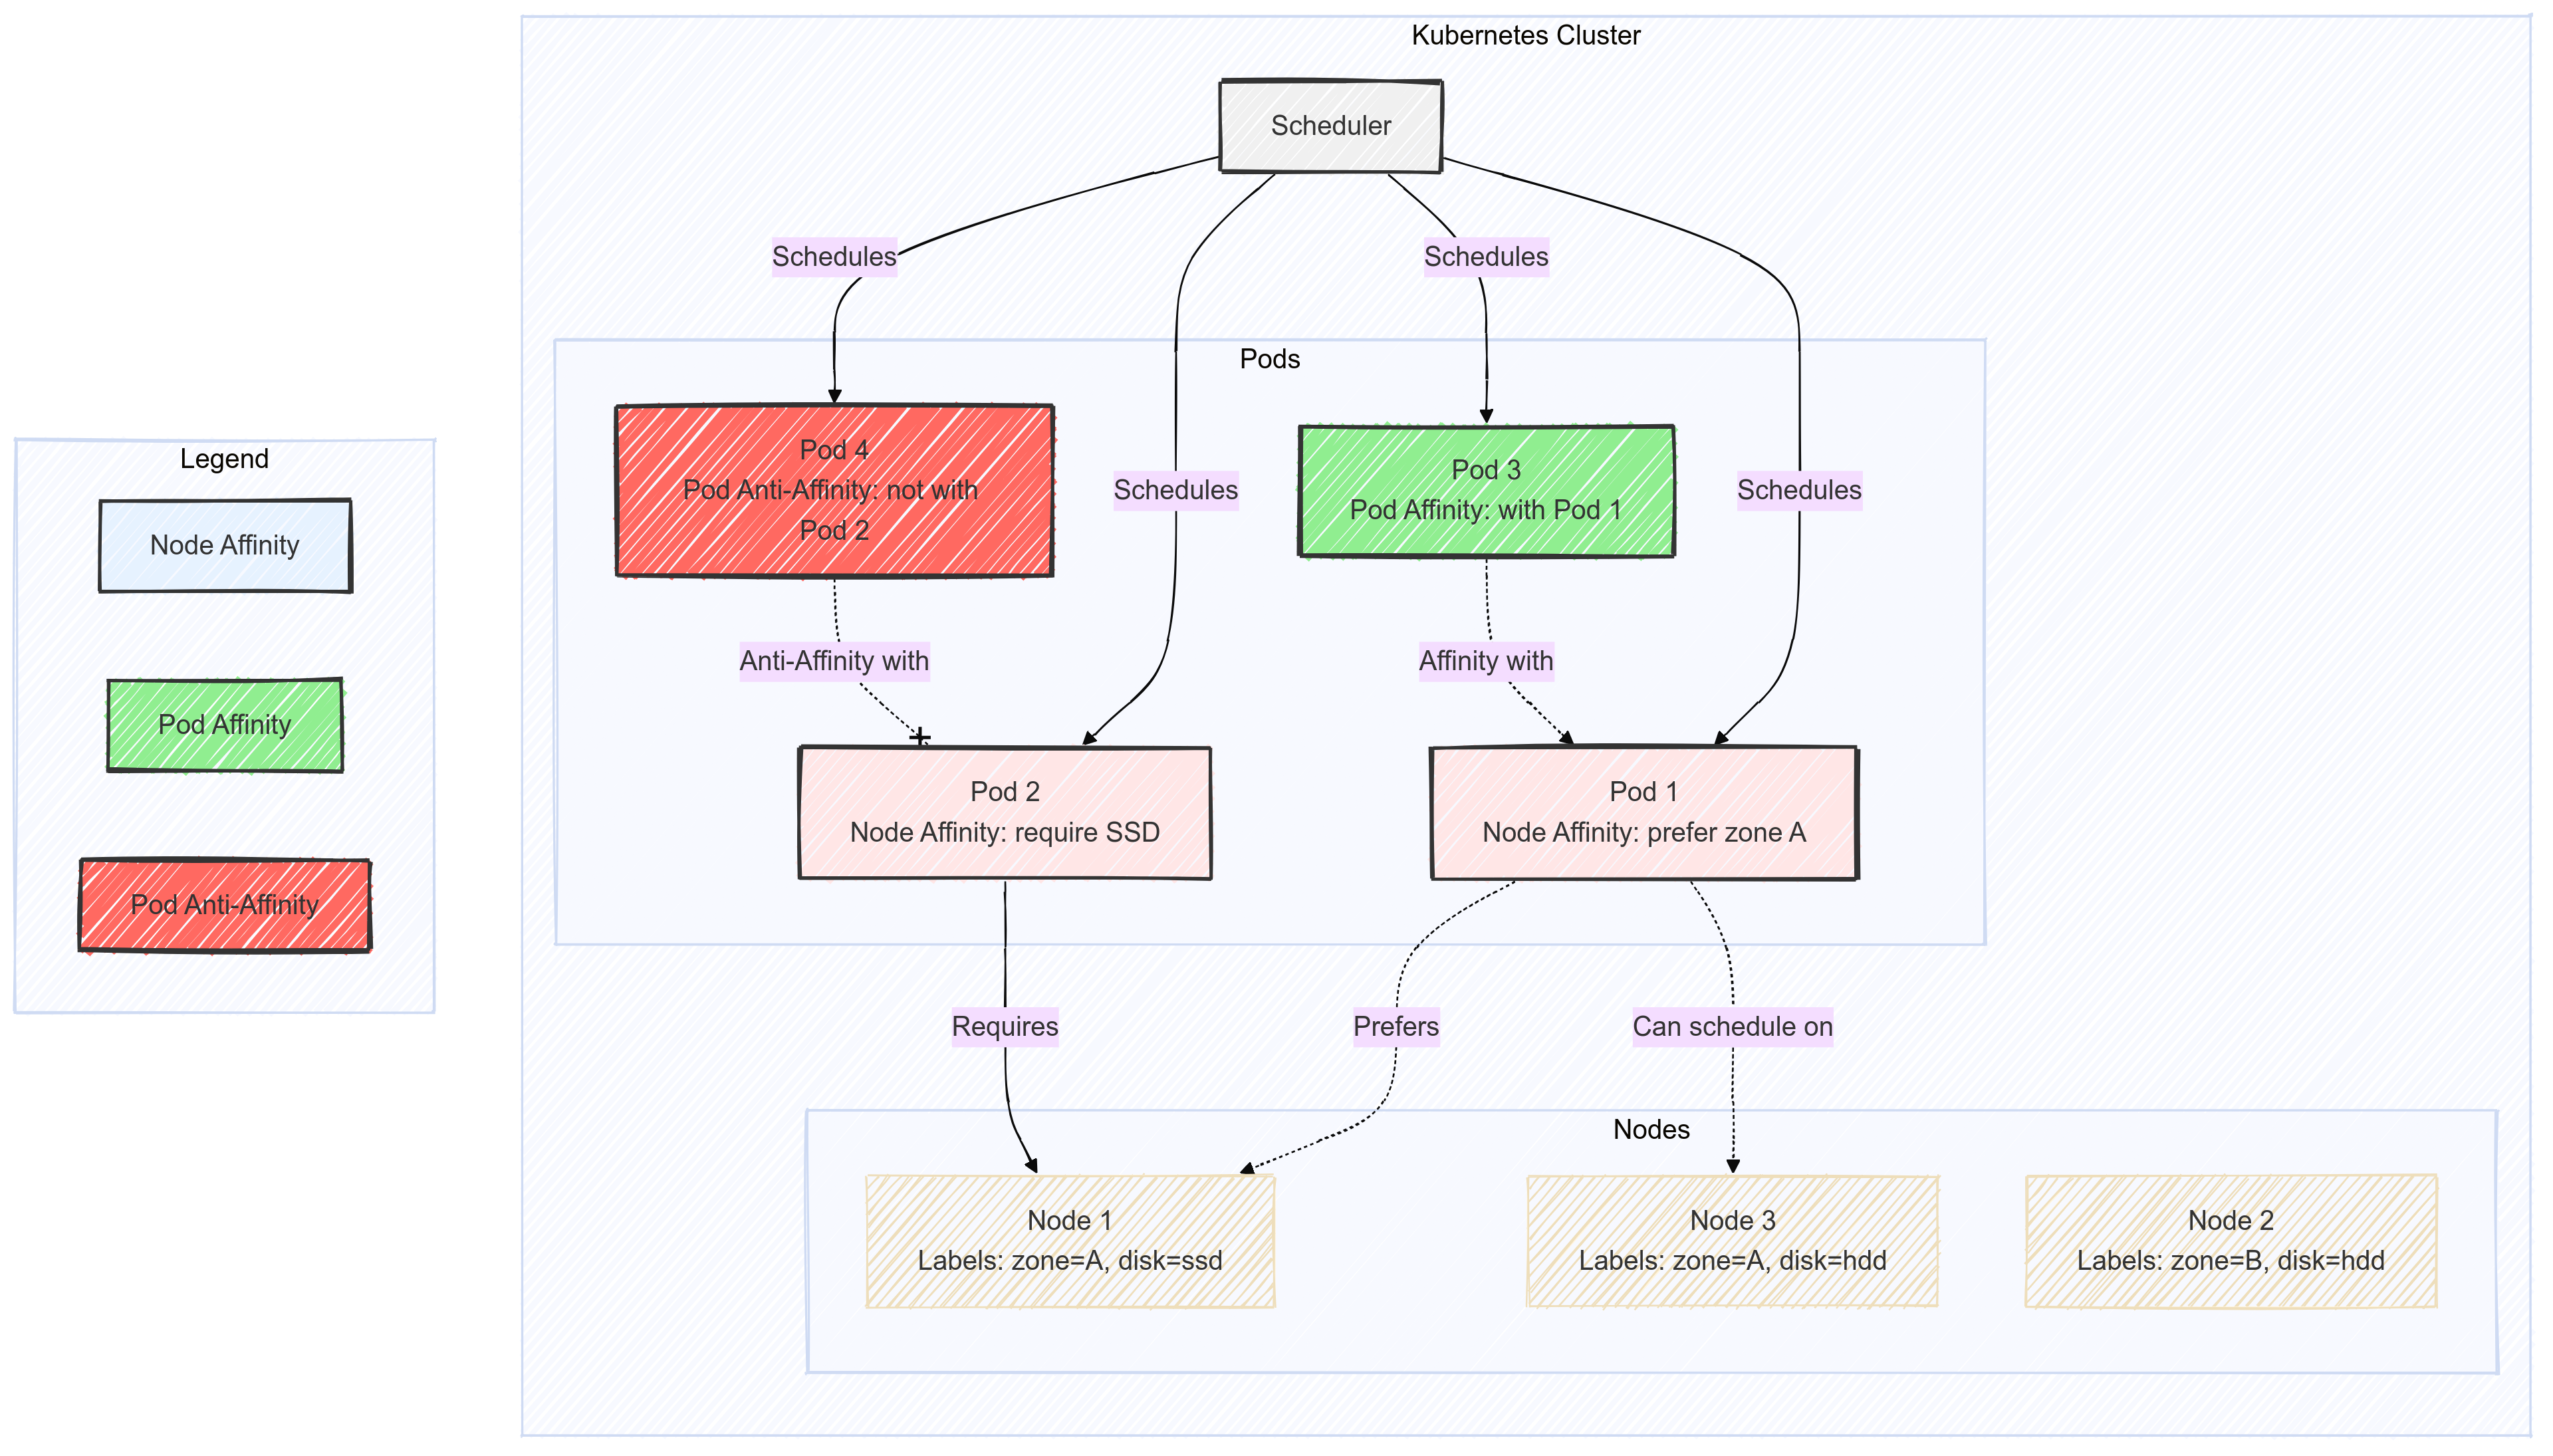
L'Objectif : Maîtriser le Placement des Pods
       ATTIRER des Pods                            REPOUSSER des Pods
  (Affinité & Sélecteurs de Nœuds)              (Taints & Tolerations)
               │                                           │
               ▼                                           ▼
"Ce pod IA DOIT tourner sur                    "Ce nœud GPU est réservé,
 des machines équipées de GPU"                  aucun pod standard n'y entre !"
Pour éviter que tous vos pods ne tombent si une seule zone de disponibilité (AZ) du Cloud crashe :
spec:topologySpreadConstraints:-maxSkew: 1 # Tolérance max de déséquilibre : 1 pod d'écarttopologyKey: topology.kubernetes.io/zone # Répartir entre les datacenters / AZswhenUnsatisfiable: DoNotSchedule # Bloquer si la règle n'est pas respectéelabelSelector:matchLabels:app: bookstore-api
topologySpreadConstraints est le standard moderne recommandé pour équilibrer parfaitement les charges.
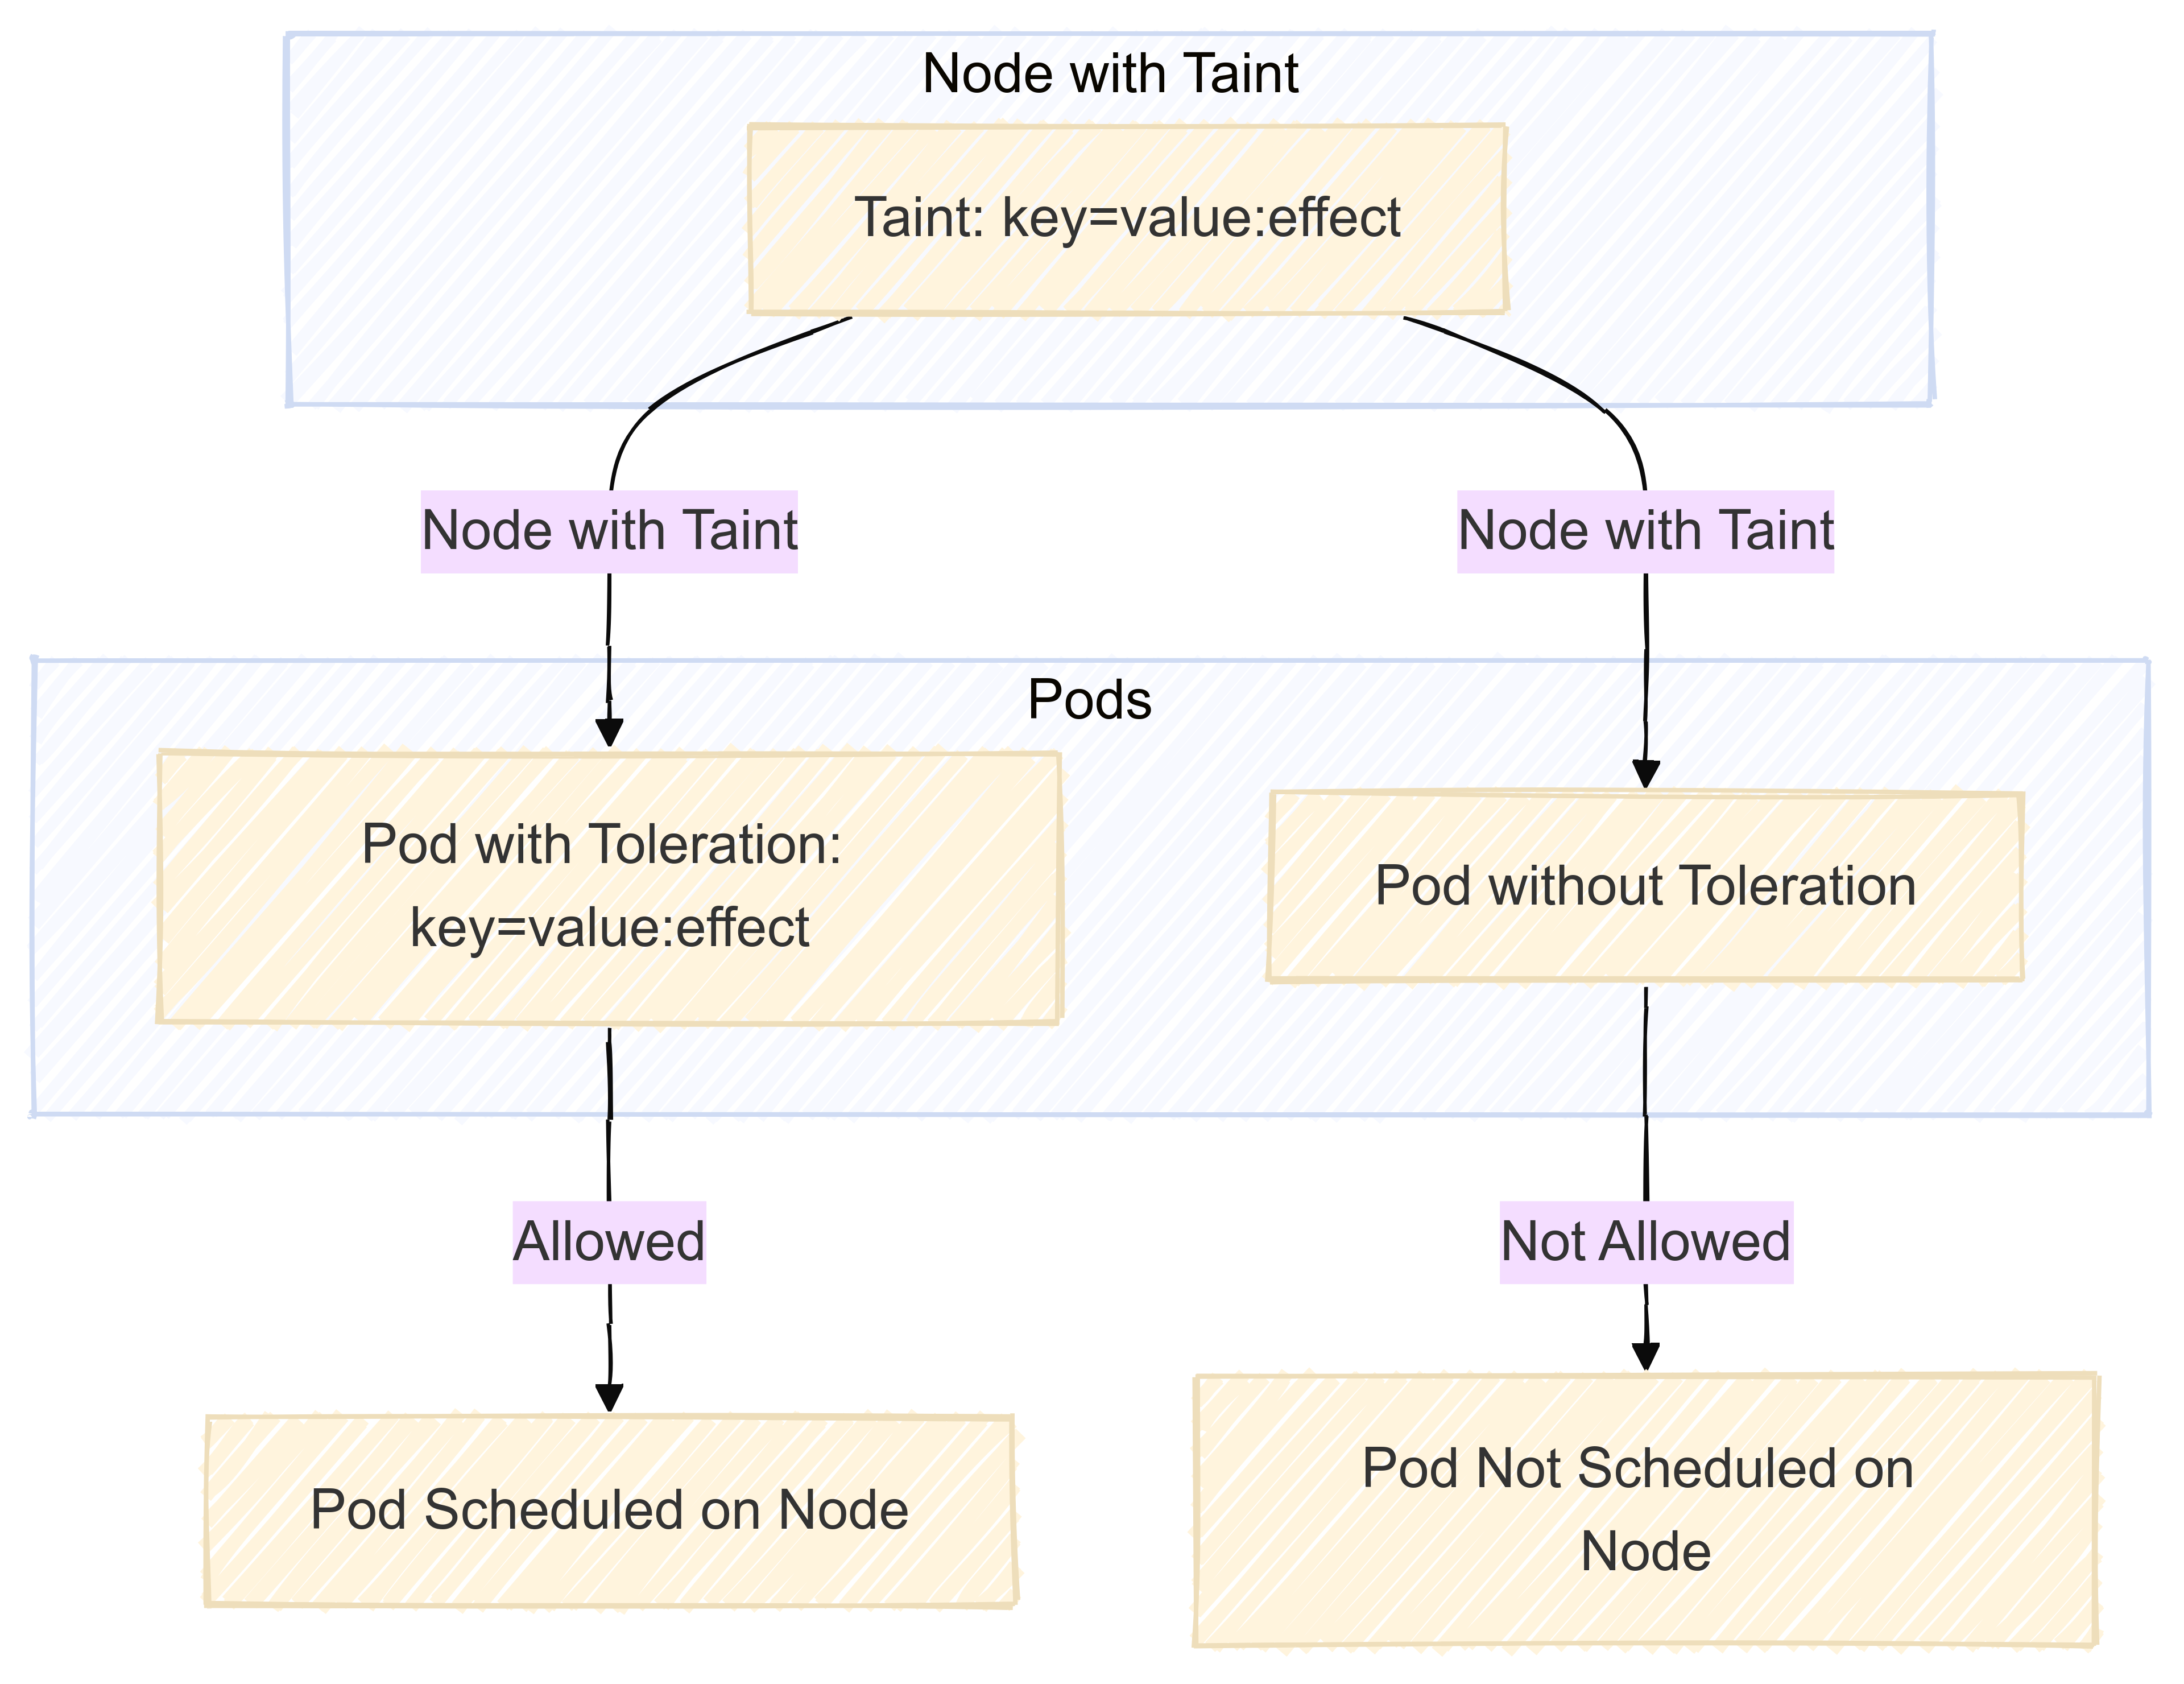
3. Taints & Tolerations : La Ségrégation des Nœuds
Taint (sur le Nœud) : kubectl taint nodes node-gpu dedicated=gpu:NoSchedule
Toleration (sur le Pod) : Seul un Pod ayant cette tolérance peut s'installer sur le nœud.
Les 3 Effets :
NoSchedule : Empêche le placement des nouveaux pods non tolérants.
PreferNoSchedule : Évite si possible, mais accepte en dernier recours.
NoExecute : Expulse immédiatement les pods déjà présents s'ils ne tolèrent pas le taint !
Résumé des Règles de Placement
Mécanisme
Portée
Type de Règle
Cas d'Usage Typique
nodeSelector
Nœud
Binaire (Strict)
Cibler un type d'instance simple (ex: SSD)
nodeAffinity
Nœud
Hard (required) / Soft (preferred)
Ciblage multi-zones & architectures CPU
podAntiAffinity
Pod ↔ Pod
Hard / Soft
Répartir les réplicas sur des hôtes distincts
topologySpread
Nœuds / Zones
Étalement uniforme
Équilibrer les pods sur plusieurs AZs
Taints / Tolerations
Nœud ↔ Pod
Répulsion (NoSchedule / NoExecute)
Nœuds GPU, isolation Control Plane, maintenance
Mini-Défi : Le Pod Éjecté
Question flash : Vous exécutez la commande suivante sur un worker node hébergeant 10 pods de production : kubectl taint node worker-1 maintenance=true:NoExecute
Que se passe-t-il pour ces 10 pods ?
Mini-Défi : Le Pod Éjecté
Question flash : Vous exécutez la commande suivante sur un worker node hébergeant 10 pods de production : kubectl taint node worker-1 maintenance=true:NoExecute
Que se passe-t-il pour ces 10 pods ?
Réponse : S'ils n'ont pas de tolerations explicite pour maintenance=true, ils sont immédiatement tués et expulsés (NoExecute). Le Deployment Controller recréera de nouveaux pods sur les autres nœuds sains.
KUBERNETES : Stockage Persistant & CSI
Éphémère vs Persistant : L'Architecture du Stockage
           ÉPHÉMÈRE                                       PERSISTANT
  (Meurt avec le Pod)                         (Survit à la destruction du Pod)
           │                                                  │
           ▼                                                  ▼
  emptyDir / configMap / secret                  PersistentVolumeClaim (PVC)
  Cache local, scratchpad, RAM                   Bases de données, fichiers partagés
Les Volumes Éphémères
emptyDir :
Créé au démarrage du Pod, détruit à sa mort.
Idéal pour partager des fichiers temporaires entre un conteneur principal et un sidecar.
Peut être monté en RAM (medium: Memory) pour des performances maximales.
hostPath :
Monte un dossier physique du Worker Node (ex: /var/log).
⚠️ Danger en production : Si le pod migre sur un autre nœud, il ne retrouve pas ses données.
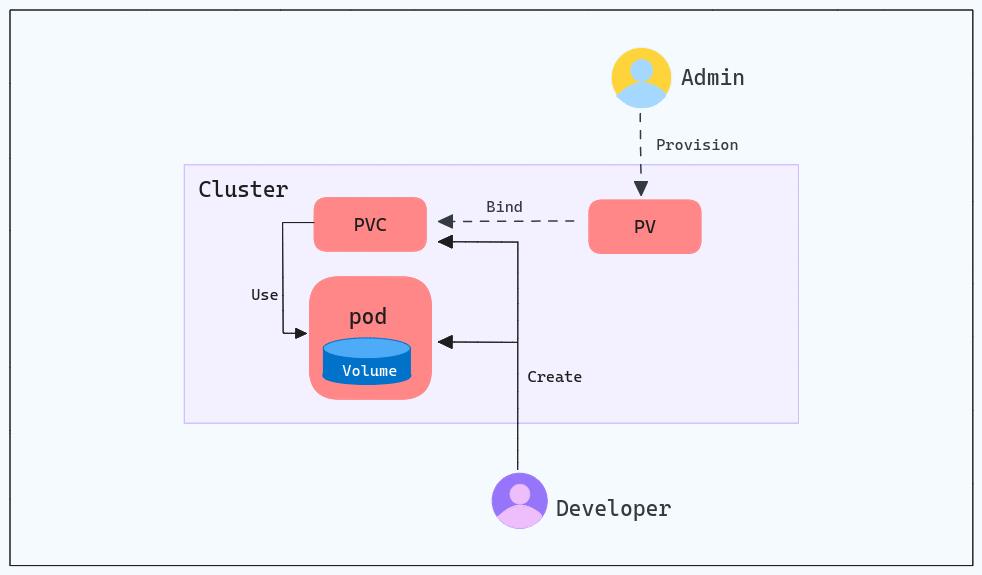
Le Trio Gagnant : StorageClass, PV & PVC
  1. L'Administrateur déclare le fournisseur
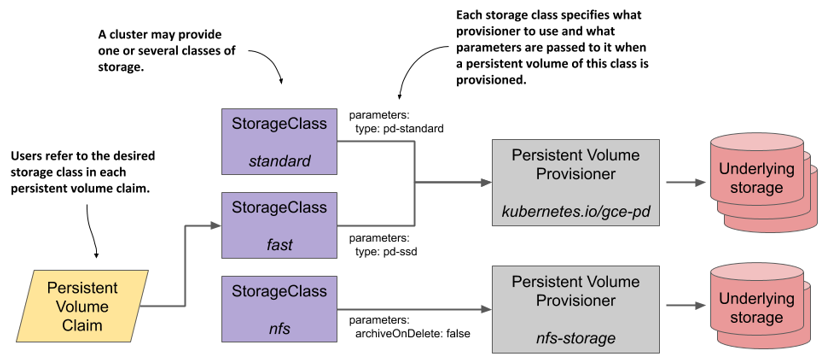
     [ StorageClass: "fast-ssd" ] (AWS gp3, GCP pd-ssd, Ceph)
                  │
                  ▼ (Provisionnement Dynamique automatique)
  2. Le Développeur demande du stockage
     [ PersistentVolumeClaim (PVC) : 50Gi, ReadWriteOnce ]
                  │
                  ▼ (Liaison / Binding automatique)
  3. Kubernetes crée le volume physique
     [ PersistentVolume (PV) : 50Gi alloué sur le Cloud/SAN ]
                  │
                  ▼
  4. Monté dans le Pod : /var/lib/postgresql/data
Les Modes d'Accès aux Volumes
Mode d'Accès
Abréviation
Description
Exemples Typiques
ReadWriteOnce
RWO
Montable en lecture/écriture par 1 seul Nœud à la fois
Disques Blocs Cloud (AWS EBS, GCP PD, Azure Disk)
ReadOnlyMany
ROX
Montable en lecture seule par plusieurs Nœuds
Dépôt de binaires, modèles IA statiques
ReadWriteMany
RWX
Montable en lecture/écriture par plusieurs Nœuds simultanément
NFS, CephFS, AWS EFS, Azure Files
ReadWriteOncePod
RWOP
Montable en lecture/écriture par 1 seul Pod unique
Le StorageClass s'occupe d'appeler l'API Cloud (via le driver CSI) pour créer le disque automatiquement.
Politiques de Récupération (Reclaim Policy)
Que devient le disque physique (PV) quand le développeur supprime le PVC ?
Delete (par défaut) : Le volume physique dans le Cloud/SAN est immédiatement détruit.
Retain (recommandé en production) : Le volume physique est conservé avec ses données pour permettre une récupération manuelle en cas d'erreur humaine.
Mini-Défi : Le PVC Bloqué en Pending
Scénario d'incident : Vous créez un PVC avec storageClassName: standard et accessModes: [ReadWriteMany] sur un cluster EKS avec disques EBS.
Le PVC reste indéfiniment en statut Pending. Pourquoi ?
Mini-Défi : Le PVC Bloqué en Pending
Scénario d'incident : Vous créez un PVC avec storageClassName: standard et accessModes: [ReadWriteMany] sur un cluster EKS avec disques EBS.
Le PVC reste indéfiniment en statut Pending. Pourquoi ?
Réponse : Les disques blocs EBS d'AWS ne supportent que le mode ReadWriteOnce (RWO). Le provisionneur CSI refuse d'allouer un disque EBS pour une demande de type ReadWriteMany (RWX), qui nécessite un système de fichiers distribué comme EFS / NFS
KUBERNETES : Réseau, Services & Découverte DNS
Le Problème : Les Adresses IP des Pods Sont Mortelles !
 [ Pod Web 1 (10.244.1.42) ] ──► (Meurt) ──► [ Nouveau Pod (10.244.2.89) ]
                                                   ▲
                                                   │
  "Comment le Frontend peut-il joindre le Backend si son IP change sans cesse ?"
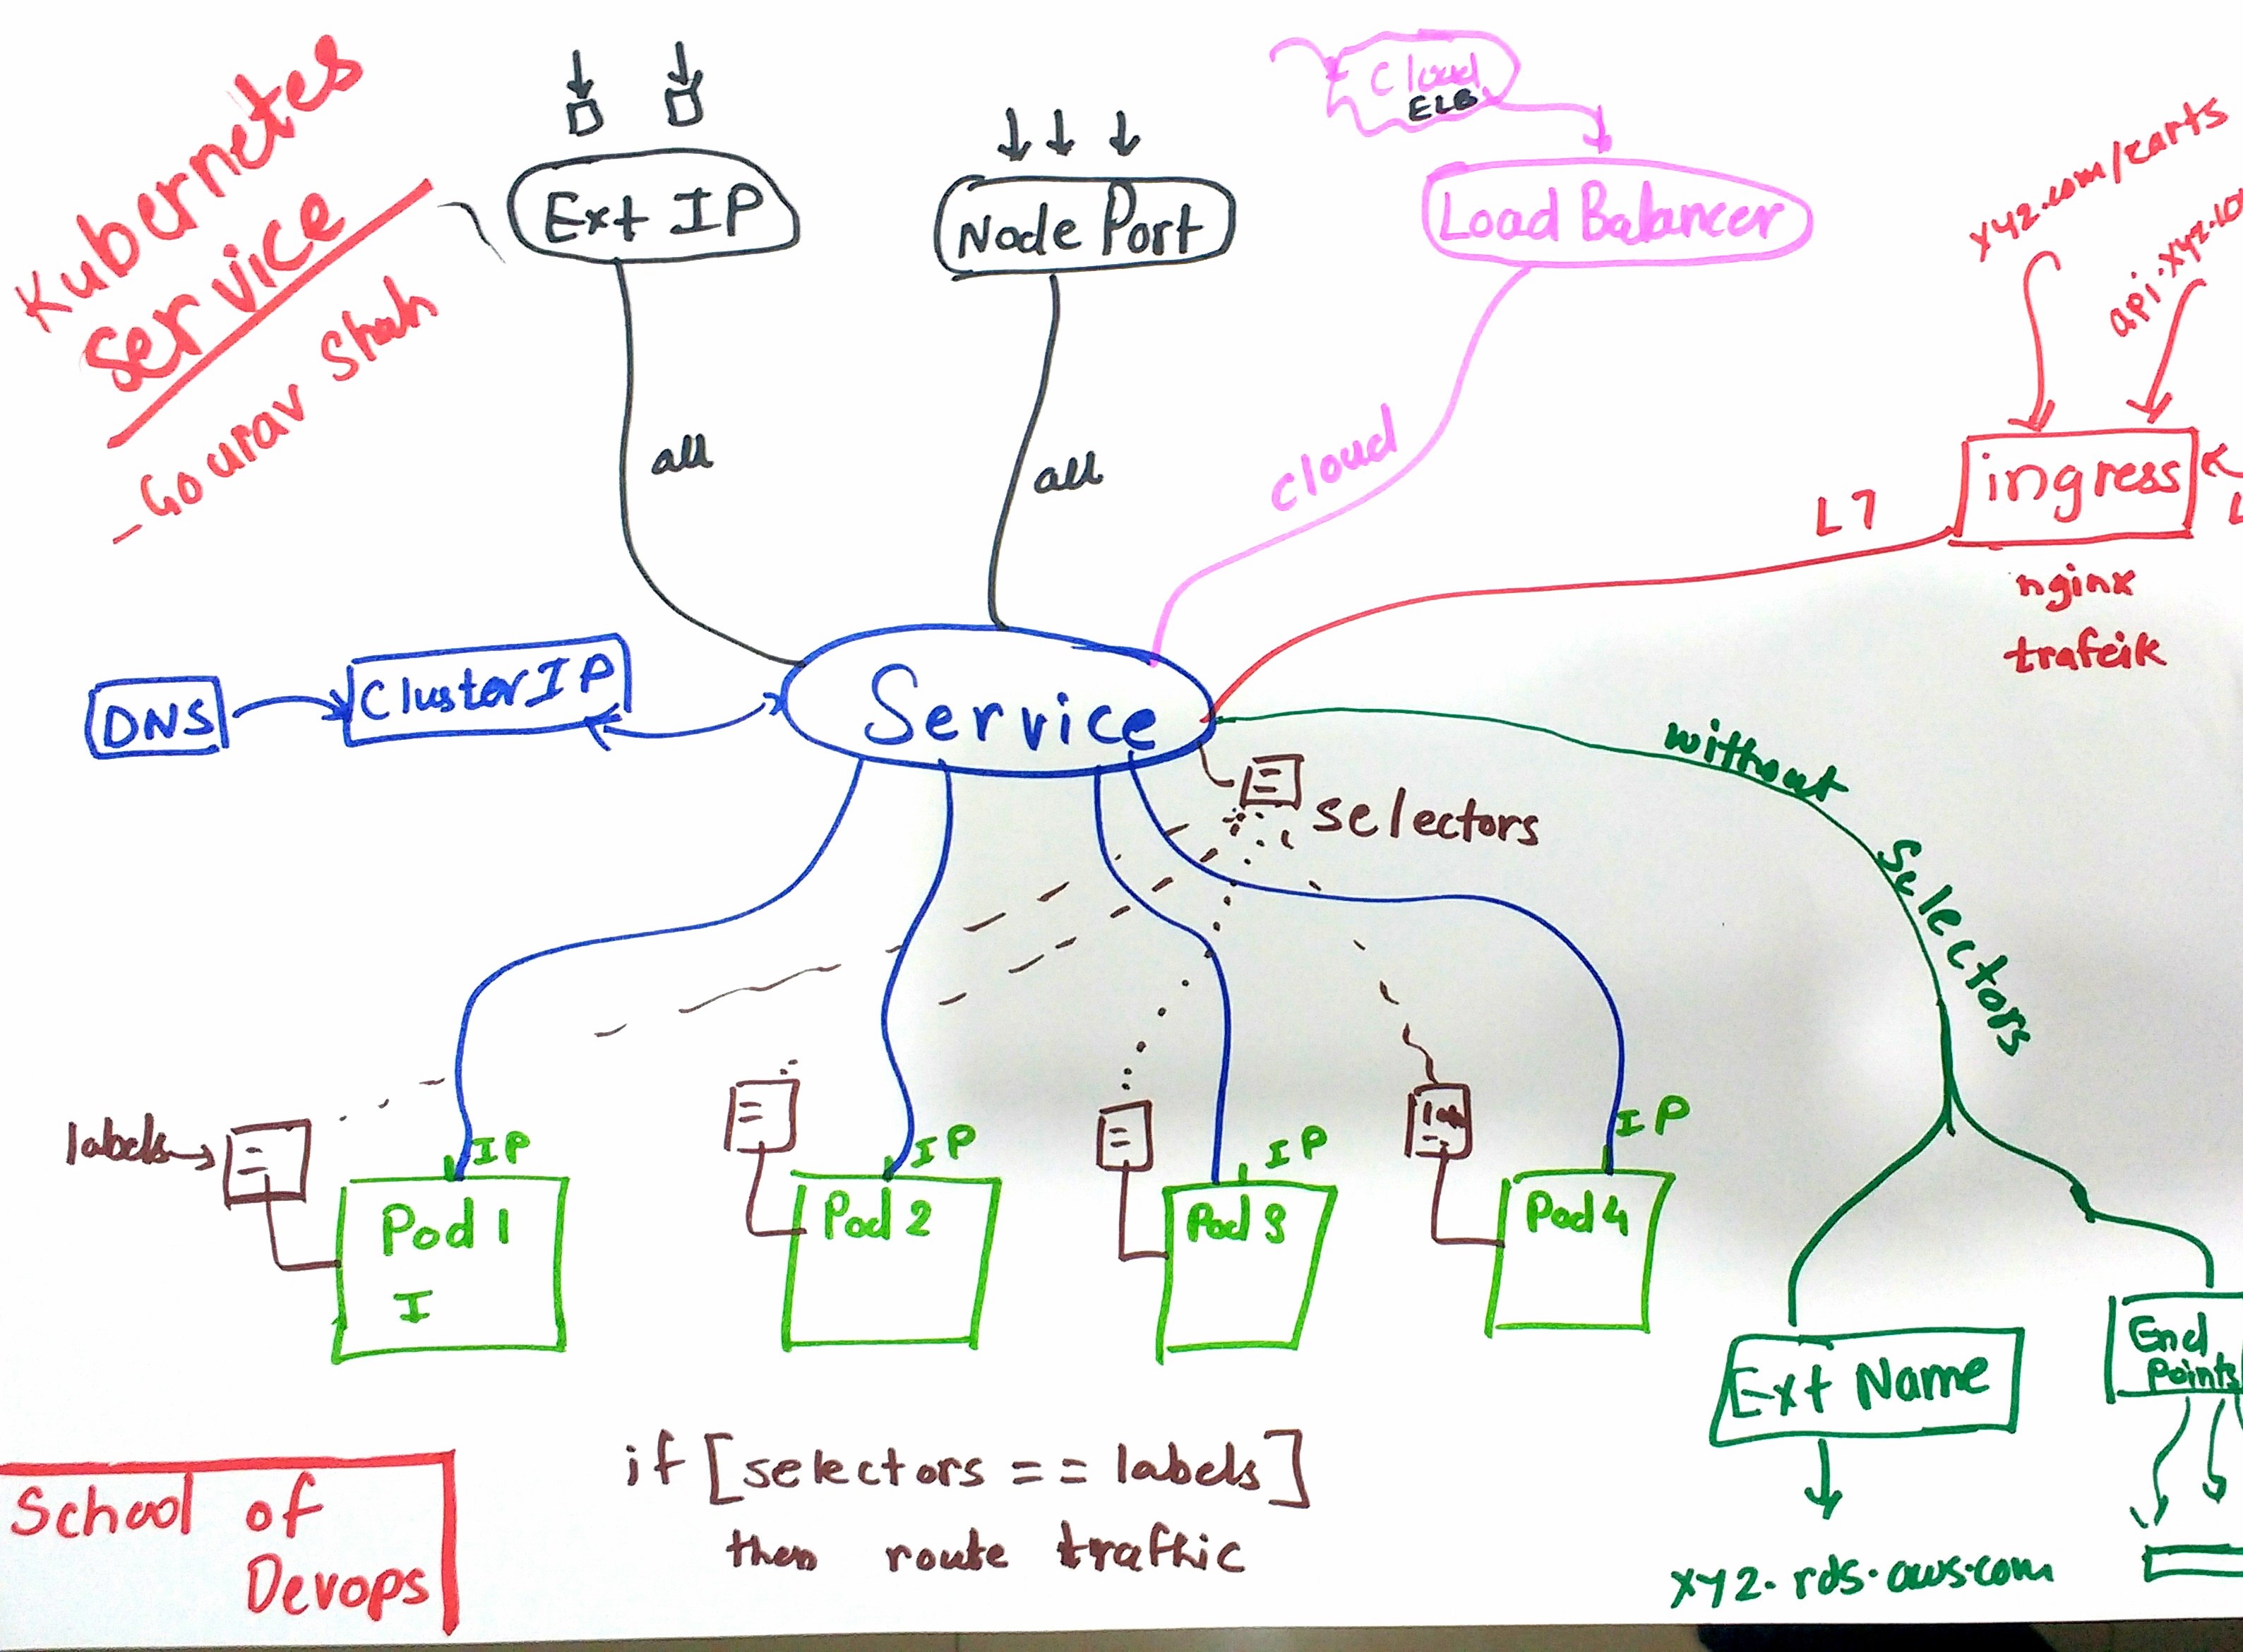
La Solution : L'Objet Service
Fournit une IP Virtuelle stable (ClusterIP) qui ne change jamais.
Fournit un Nom DNS interne résolu par CoreDNS.
Répartit la charge (Load Balancing L4) vers tous les Pods sains correspondants.
1. La Découverte DNS Interne (CoreDNS)
Chaque Service enregistré reçoit automatiquement un nom DNS FQDN :
         [ LoadBalancer ]          (Cloud Public : AWS NLB / GCP LB)
                │
                ▼
           [ NodePort ]            (Port 30000-32767 sur chaque Nœud)
                │
                ▼
          [ ClusterIP ]            (IP Virtuelle interne au Cluster)
                │
                ▼
[ Pod 1 ]   [ Pod 2 ]   [ Pod 3 ]
Typologie Détaillée des Services
Type de Service
Portée
Adresse IP
Cas d'Usage
ClusterIP (Défaut)
Interne au cluster
IP Virtuelle interne
Communication Est-Ouest (API ↔ BDD)
Headless (clusterIP: None)
Interne
Aucune VIP (DNS direct vers les IPs des Pods)
StatefulSets, Kafka, Elasticsearch
NodePort
Accessible depuis l'extérieur
Port élevé (30000-32767)
Dev local, passerelles bare-metal
LoadBalancer
Public Internet
IP Publique Cloud managée
Exposition externe principale d'un cluster Cloud
ExternalName
Interne → Externe
Alias CNAME DNS
Rediriger vers une BDD managée (ex: RDS AWS)
3. Sous le Capot : Les Endpoints & EndpointSlice
Comment le Service sait-il où envoyer le trafic ?
[ Service (port: 80) ] ──► [ EndpointSlice ] ──► [ Pod 1: 10.244.1.15:8080 ]
   (Sélecteur: app=web)                             [ Pod 2: 10.244.2.20:8080 ]
# Vérifier la liste des pods réellement connectés au servicekubectl get endpoints mon-service
kubectl get endpointslices -l kubernetes.io/service-name=mon-service
Si kubectl get endpoints renvoie <none>, aucun pod ne recevra jamais de trafic !
Manifeste YAML Type d'un Service
apiVersion: v1kind: Servicemetadata:name: bookstore-backendspec:type: ClusterIPselector:app: bookstoretier: backendports:-name: httpprotocol: TCPport: 80 # Le port exposé par le ServicetargetPort: 8080 # Le port réel écouté dans le conteneur du Pod
Mini-Défi : Le Service Fantôme
Incident SRE : Vous créez un Service auth-service pour exposer 3 Pods. Lorsque vous faites curl auth-service depuis un autre Pod, la requête renvoie instantanément : Connection refused.
Quand vous tapez kubectl get endpoints auth-service, la colonne ENDPOINTS affiche <none>.
Quelles sont les 2 causes les plus probables ?
Mini-Défi : Le Service Fantôme
Incident SRE : Vous créez un Service auth-service pour exposer 3 Pods. Lorsque vous faites curl auth-service depuis un autre Pod, la requête renvoie instantanément : Connection refused.
Quand vous tapez kubectl get endpoints auth-service, la colonne ENDPOINTS affiche <none>.
Quelles sont les 2 causes les plus probables ?
Réponses :
Le sélecteur de labels du Service ne correspond pas aux labels des Pods.
Les Pods ne passent pas leurs Readiness Probes (Pods non Ready), donc Kubernetes les a retirés des Endpoints.
          APPROCHE NAÏVE (L4)                           APPROCHE INGRESS / L7
 50 Services type LoadBalancer                 1 SEUL Load Balancer Cloud Public
  = 50 IP publiques à payer                     = 1 seule IP, routage L7 intelligent
  = Facture Cloud x50 !                         = Répartition par nom de domaine & URL !
Ingress Controller : Le proxy inverse (NGINX, Traefik, Envoy, HAProxy) qui écoute le trafic mondial.
Ressource Ingress : La règle déclarative qui indique à quel Service envoyer chaque URL.
1. Ingress Class & Contrôleurs
Déployer un Ingress Controller (ex: ingress-nginx).
Déclarer une IngressClass pour indiquer quel contrôleur doit interpréter vos règles.
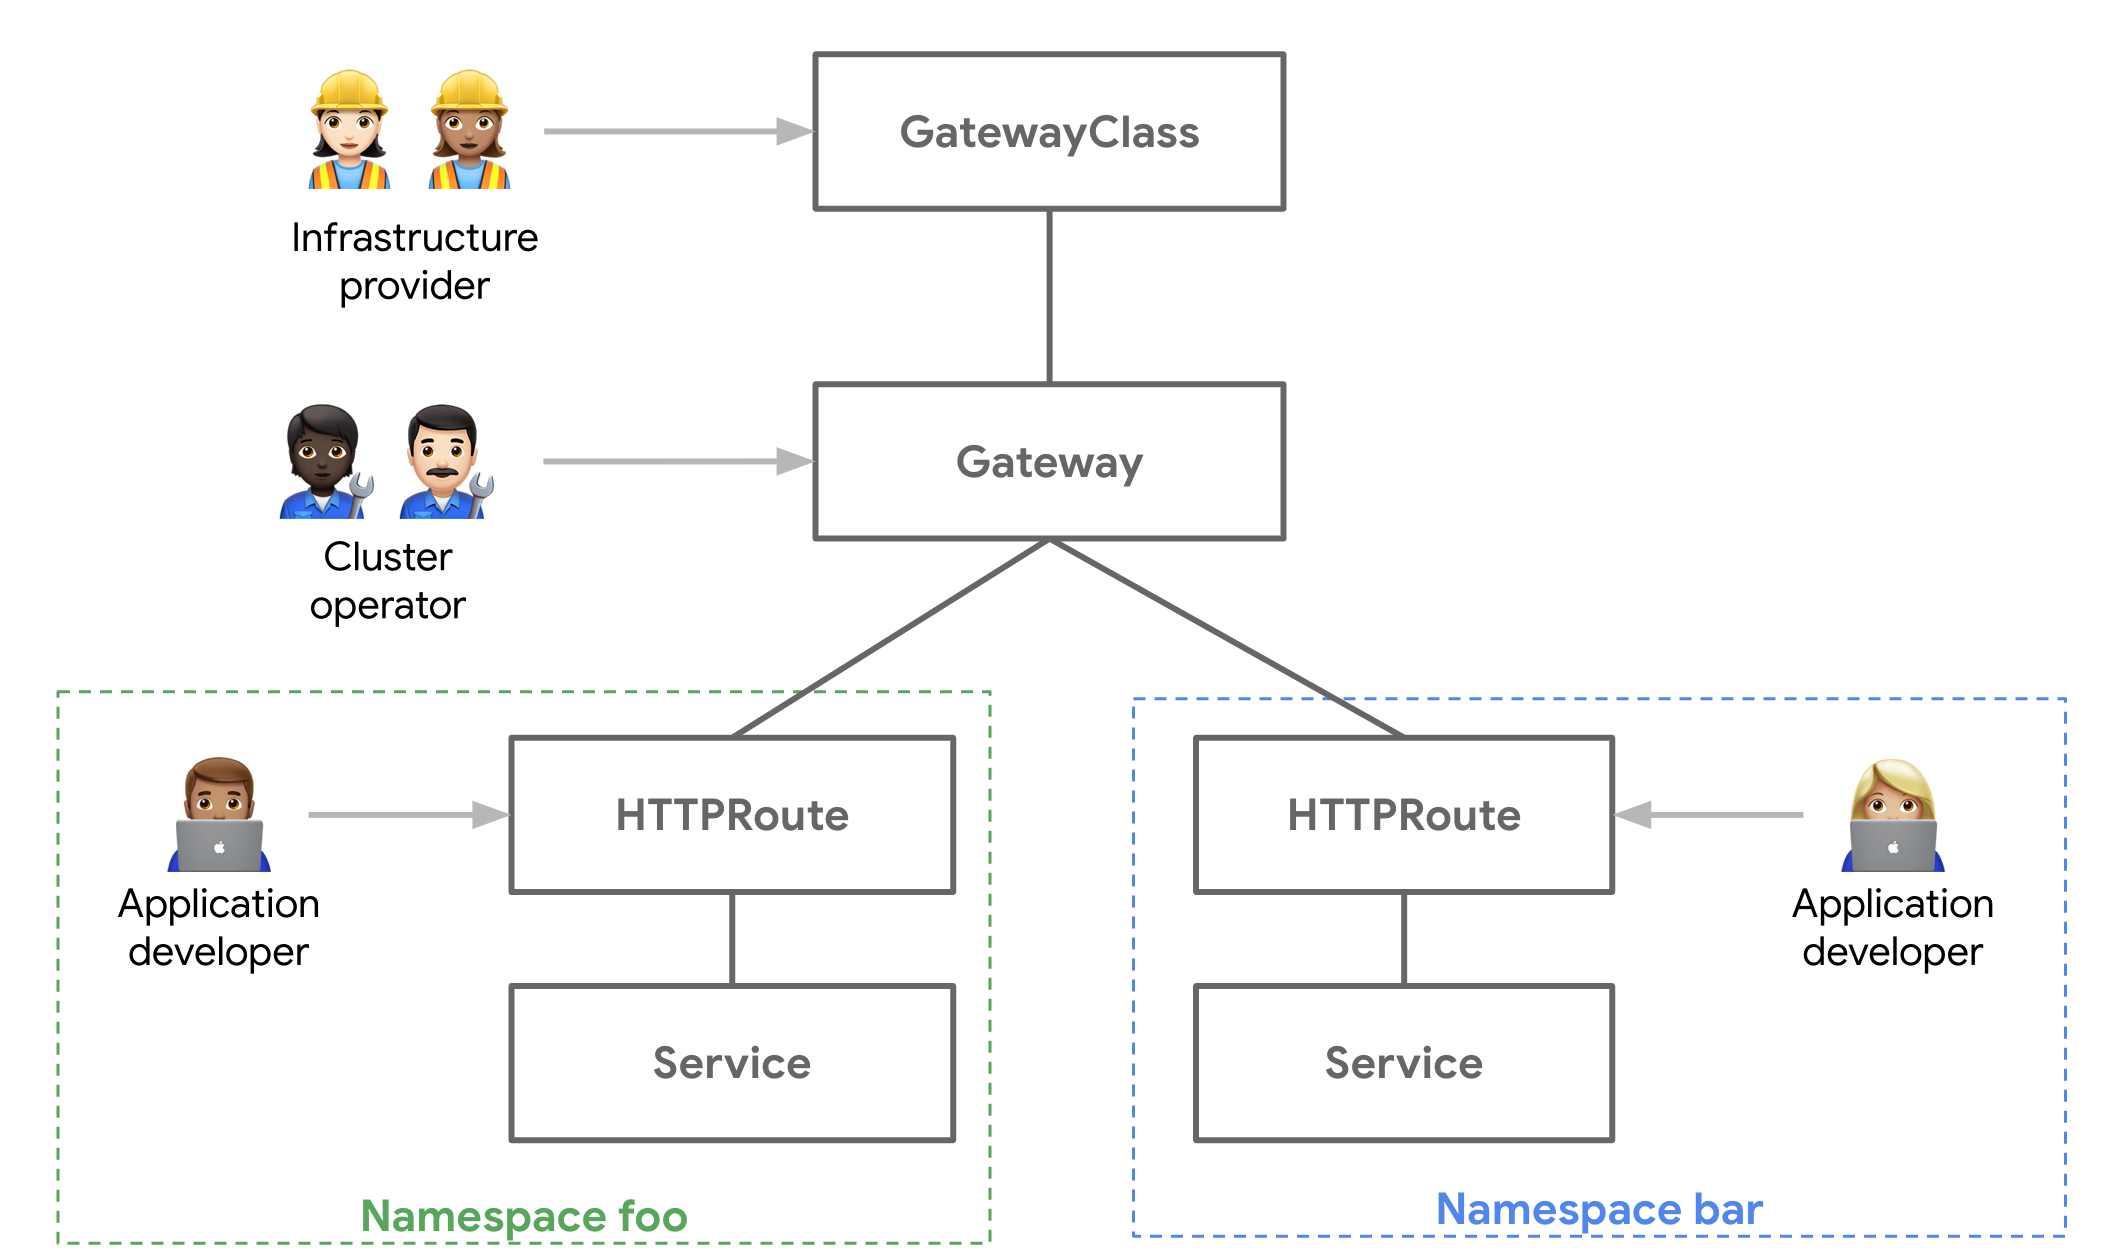
La Gateway API est le successeur officiel de l'Ingress standard, conçu pour les architectures modernes et la séparation des responsabilités :
┌─────────────────────────────────────────────────────────────┐
│                                                             │
│ ÉQUIPE INFRA / CLOUD (Cluster Admin)                        │
│  ► GatewayClass : Définit le fournisseur (Envoy, Cilium...) │
│  ► Gateway : Déclare le point d'entrée, IP et ports 80/443  │
│                                                             │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│ ÉQUIPE DÉVELOPPEMENT / APPLICATION                          │
│  ► HTTPRoute : Règle de routage autonome par namespace      │
│  ► GRPCRoute / TCPRoute : Support natif au-delà du HTTP !   │
│                                                             │
└─────────────────────────────────────────────────────────────┘
Avantages clés : Séparation des rôles (RBAC granulaire), routage multi-namespaces, splitting de trafic natif (Canary / Blue-Green) sans annotations constructeur obscures !
Mini-Défi : Diagnostic d'une Erreur 502 / 503
Incident SRE : Un utilisateur essaie de joindre https://store.formation.com/api et obtient une erreur 502 Bad Gateway de la part d'Ingress Nginx.
Quelle est la démarche méthodique d'investigation ?
Mini-Défi : Diagnostic d'une Erreur 502 / 503
Incident SRE : Un utilisateur essaie de joindre https://store.formation.com/api et obtient une erreur 502 Bad Gateway de la part d'Ingress Nginx.
Quelle est la démarche méthodique d'investigation ?
# 1. Vérifier si l'Ingress pointe vers un service existantkubectl describe ingress bookstore-ingress
# 2. Vérifier si le Service a des Pods Endpoints actifskubectl get endpoints backend-api-svc
# 3. Vérifier les logs du contrôleur Ingress en temps réelkubectl logs -n ingress-nginx -l app.kubernetes.io/name=ingress-nginx --tail=50
KUBERNETES : Stratégies de Déploiement & Zéro Downtime
L'Objectif : Déployer en Pleine Journée Sans Peur !
   STRATÉGIE RECREATE                            STRATÉGIE ROLLING UPDATE
[ Ancien Pod ] ──► (Détruit)                    [ V1 ] [ V1 ] ──► [ V1 ] [ V2 ]
         │ (Downtime !)                                            │
         ▼                                                         ▼
[ Nouveau Pod ] ──► (Démarré)                                   [ V2 ] [ V2 ] (0 Downtime)
1. Les 4 Stratégies de Déploiement
Stratégie
Downtime
Coût Infrastructure
Risque
Cas d'Usage
RollingUpdate
0s
Faible (+1 pod de maxSurge)
Moyen
Applications stateless standard
Recreate
Oui (10s-2min)
Nul
Faible
Incompatibilité de schéma de BDD entre versions
Blue/Green
0s
Élevé (+100% de ressources)
Faible
Bascule atomique instantanée après tests réels
Canary
0s
Modéré (+5-10%)
Très faible
Envoi de 5% du vrai trafic sur la v2 (Argo Rollouts)
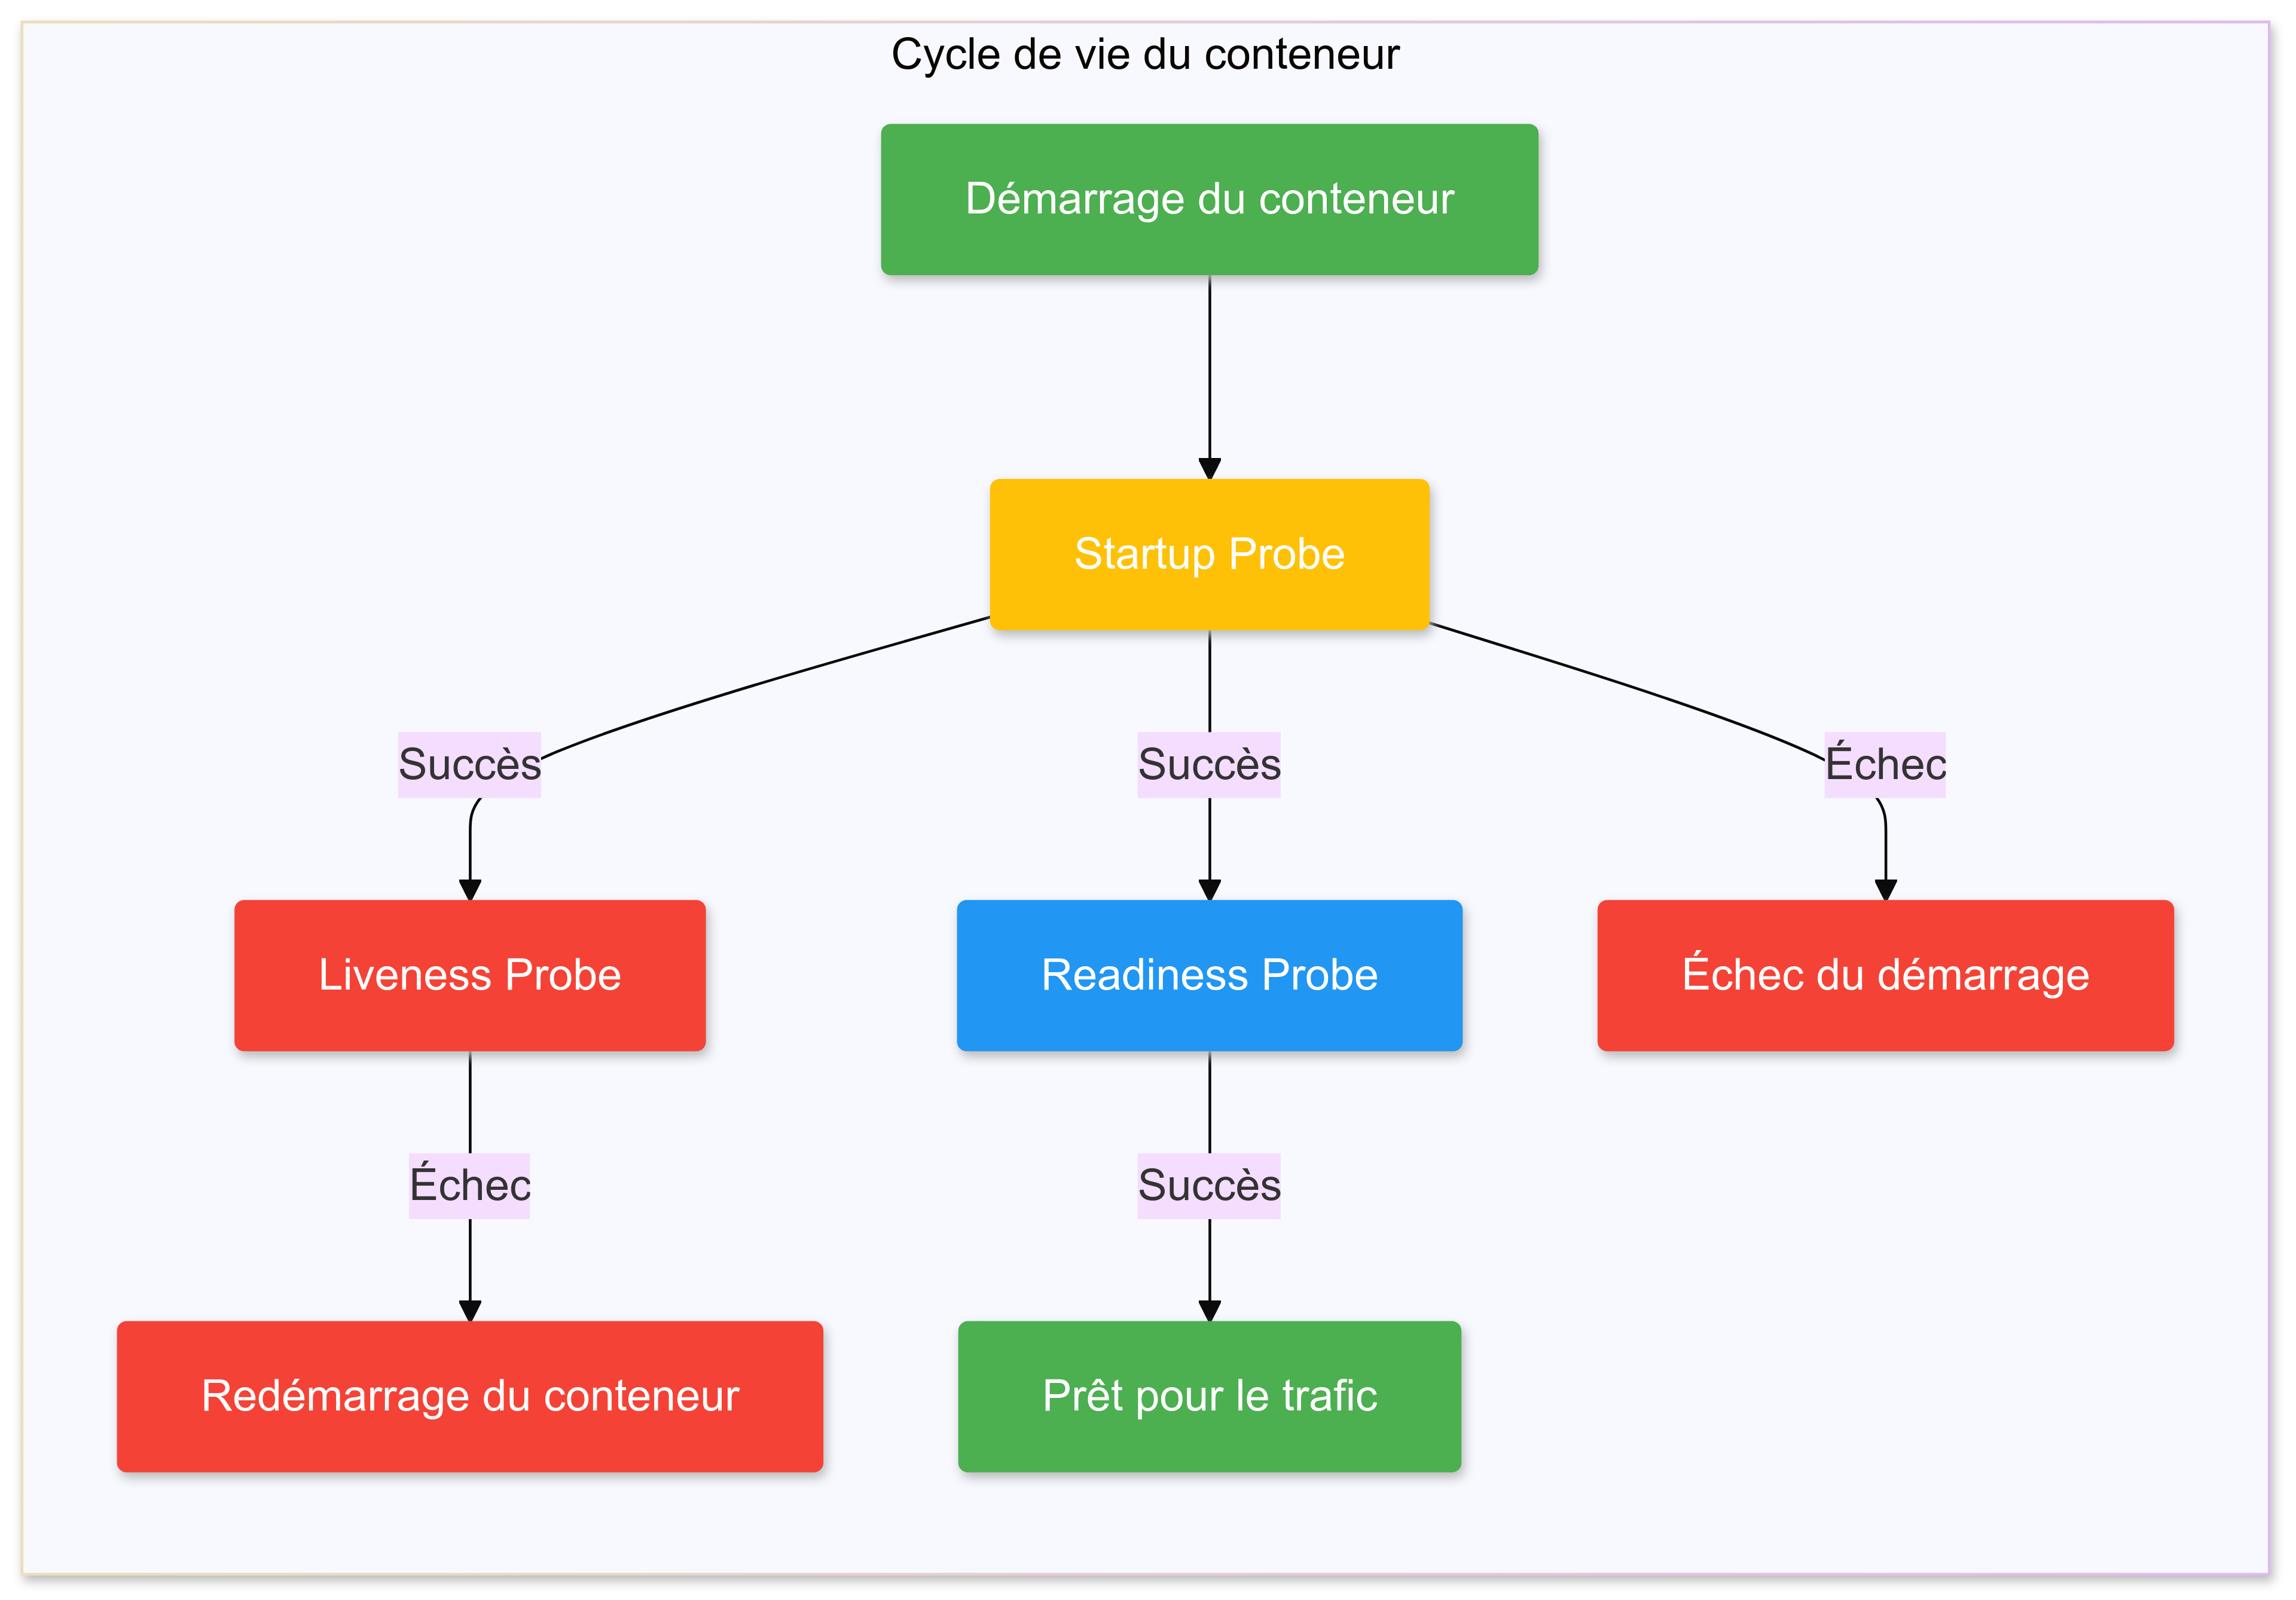
2. Le Secret du Zéro Downtime Réel : Les 3 Probes
Sans Probes bien configurées, Kubernetes envoie du trafic utilisateur à des conteneurs qui n'ont même pas fini d'initialiser leur serveur web !
   1. StartupProbe ──► "Est-ce que l'application a fini de charger ses dépendances ?"
         │ (Si OK)
         ▼
   2. ReadinessProbe ──► "Est-ce que l'application est prête à recevoir du trafic ?"
         │               (Si KO : Retiré des Endpoints du Service, 0 trafic envoyé !)
         ▼
   3. LivenessProbe ──► "Est-ce que l'application est toujours vivante ou en deadlock ?"
                         (Si KO : Le Kubelet redémarre le conteneur !)
Exemple de Configuration des Probes
spec:containers:-name: apiimage: my-app:2.0startupProbe:httpGet:path: /healthzport: 8080failureThreshold: 30periodSeconds: 2 # Laisse jusqu'à 60s pour démarrerreadinessProbe:httpGet:path: /readyport: 8080periodSeconds: 5livenessProbe:httpGet:path: /liveport: 8080periodSeconds: 10
3. L'Arrêt Propre (Graceful Shutdown)
Lorsqu'un Pod est arrêté (scale down ou rolling update) :
1. Le Pod passe en statut Terminating
2. L'IP du Pod est retirée des Endpoints (les nouvelles requêtes ne vont plus vers lui)
3. Exécution du Hook preStop (sleep 5s pour laisser le temps aux iptables de se synchroniser)
4. Envoi du signal SIGTERM au processus applicatif (pour finir les requêtes en cours)
5. Attente jusqu'à terminationGracePeriodSeconds (défaut: 30s)
6. Envoi du SIGKILL destructeur si le processus n'a pas quitté proprement
Code Review : Vous observez qu'en pic de charge, vos Pods se mettent à redémarrer en boucle de façon incontrôlable.
En inspectant la config :
livenessProbe:httpGet:path: /api/v1/check-database-and-heavy-query # <── Requête SQL complexe en BDD !
Pourquoi cette configuration est-elle une bombe à retardement en production ?
Mini-Défi : L'Erreur de la Liveness Probe
Code Review : Vous observez qu'en pic de charge, vos Pods se mettent à redémarrer en boucle de façon incontrôlable.
En inspectant la config :
livenessProbe:httpGet:path: /api/v1/check-database-and-heavy-query # <── Requête SQL complexe en BDD !
Pourquoi cette configuration est-elle une bombe à retardement en production ?
Réponse : Si la base de données ralentit ou sature, la liveness probe échoue en timeout. Kubernetes croit à tort que le Pod web est mort et le tue, provoquant une cascade de redémarrages catastrophique (thundering herd). La Liveness Probe doit être locale et ultra-légère !.
┌─────────────────────────────────────────────────────────────┐
|                                                             |
│ 1. HPA (Horizontal Pod Autoscaler) : Varie le NOMBRE de Pods│
│    [ Pod ] ──► [ Pod ] [ Pod ] [ Pod ] [ Pod ]              |
|                                                             |
├─────────────────────────────────────────────────────────────┤
|                                                             |
| 2. VPA (Vertical Pod Autoscaler) : Varie la TAILLE du Pod   |
│    [ Petit Pod (1 CPU) ] ──► [ GROS Pod (4 CPU) ]           |
|                                                             |
├─────────────────────────────────────────────────────────────┤
|                                                             |
| 3. Cluster Autoscaler / Karpenter : Varie le NOMBRE de NŒUDS|
│    [ Node 1 ] ──► [ Node 1 ] [ Node 2 ] [ Node 3 ]          |
|                                                             |
└─────────────────────────────────────────────────────────────┘
1. Horizontal Pod Autoscaler (HPA v2)
Le HPA interroge metrics-server toutes les 15 secondes pour adapter le nombre de réplicas :
Comment identifier quel microservice ralentit une transaction utilisateur sur 15 étapes ?
[ Client ] ──► [ Frontend ] (20ms)
                   │
                   ▼
               [ Auth API ] (15ms)
                   │
                   ▼
               [ Payment Gateway ] ──► (Bloqué 3.2s sur la banque !)
OpenTelemetry Collector reçoit les traces (spans), corrèle les contextes distribués (traceparent) et les stocke dans Jaeger ou Grafana Tempo.
3. Monitoring CLI Temps Réel : k9s & kubectl top
# Vérifier la consommation réelle instantanéekubectl top nodes
kubectl top pods -A --sort-by=memory
# Ouvrir k9s (TUI interactif pour naviguer dans les pods, logs et métriques)k9s
Mini-Défi : Alerte PromQL
Question SRE : Vous devez écrire une règle d'alerte pour être réveillé uniquement si le taux d'erreur 5xx de votre API dépasse 5% pendant 5 minutes.
Mini-Défi : Alerte PromQL
Question SRE : Vous devez écrire une règle d'alerte pour être réveillé uniquement si le taux d'erreur 5xx de votre API dépasse 5% pendant 5 minutes.
KUBERNETES : Centralisation des Logs (Loki, Fluent Bit & Vector)
Le Flux des Logs dans Kubernetes
 [ Pod Container ] ──► Écrit sur stdout / stderr
                             │
                             ▼ (Géré par le CRI : containerd)
  Fichier JSON local : /var/log/pods/<namespace>_<pod>_<uid>/...
                             │
                             ▼ (Scrapé par un DaemonSet sur le Nœud)
               [ Fluent Bit / Promtail / Vector ]
                             │
                             ▼ (Envoi compressé)
               [ Grafana Loki / OpenSearch ]
1. Pourquoi stdout/stderr est la Règle d'Or ?
Les conteneurs doivent toujours écrire leurs logs sur la sortie standard (stdout) et la sortie d'erreur standard (stderr).
containerd capture ces flux, gère la rotation automatique des fichiers sur le disque du nœud hôte et les expose via kubectl logs.
# Consulter les logs en direct d'un Podkubectl logs -f deployment/bookstore-api
# Voir les logs d'un conteneur spécifique dans un Pod multi-conteneurskubectl logs pod-avec-sidecar -c mon-application
# Consulter les logs du conteneur AVANT son dernier crash (Indispensable !)kubectl logs mon-pod -p
2. Le Modèle de Collecte : DaemonSet vs Sidecar
Modèle
Consommation Ressources
Complexité
Cas d'Usage Recommandé
DaemonSet (Node-level)
Très faible (1 seul agent par serveur physique)
Simple et transparent pour les devs
95% des cas en production (Fluent Bit, Vector)
Sidecar (Pod-level)
Élevée (1 conteneur en plus par Pod)
Spécifique
Applications legacy écrivant dans un fichier rigide /var/log/app.log
3. La Stack Moderne : Grafana Loki & LogQL
Contrairement à ElasticSearch qui indexe l'intégralité du texte des logs (gourmand en RAM/Disque), Grafana Loki indexe uniquement les métadonnées (labels K8s) :
# Requête LogQL pour filtrer les erreurs 500 sur le namespace production
{namespace="production", app="bookstore"} |= "ERROR" | json | status_code >= 500
Mini-Défi : Le Crash Mystère
Incident SRE : Un Pod s'est crashé il y a 30 secondes et vient d'être recréé par son ReplicaSet. Quand vous tapez kubectl logs mon-pod, vous ne voyez que 2 lignes de démarrage, les logs de l'erreur qui a causé la mort du pod ont disparu.
Quelle option magique de kubectl logs permet de voir les derniers instants du conteneur décédé ?
Mini-Défi : Le Crash Mystère
Incident SRE : Un Pod s'est crashé il y a 30 secondes et vient d'être recréé par son ReplicaSet. Quand vous tapez kubectl logs mon-pod, vous ne voyez que 2 lignes de démarrage, les logs de l'erreur qui a causé la mort du pod ont disparu.
Quelle option magique de kubectl logs permet de voir les derniers instants du conteneur décédé ?
KUBERNETES : Troubleshooting & Scènes de Crime (CSI)
La Méthodologie d'Investigation en 4 Étapes
[ 1. ÉTAT GLOBAL ] ──► kubectl get pods -o wide (Identifier les coupables)
        │
        ▼
[ 2. AUTOPSIE ]    ──► kubectl describe pod <nom> (Section Events & Last State)
        │
        ▼
[ 3. DERNIERS MOTS ] ──► kubectl logs <nom> --previous (Pourquoi a-t-il crashé ?)
        │
        ▼
[ 4. INFILTRATION ]  ──► kubectl debug -it <nom> --image=busybox (Debug éphémère)
Le Guide des Statuts de Pods
Statut Affiché
Signification Réelle
Cause Racine Typique
ImagePullBackOff
Impossible de télécharger l'image
Erreur de nom de tag, registre privé sans imagePullSecrets
CrashLoopBackOff
L'app démarre puis s'arrête en erreur
Variable d'environnement manquante, erreur de config, exit code ≠0
OOMKilled (Exit 137)
Tué par le noyau Linux
L'application a dépassé sa resources.limits.memory
Pending
Le scheduler ne trouve aucun nœud
Pas assez de CPU/RAM libre, Taints sans Tolerations, PVC non lié
CreateContainerConfigError
Configuration invalide
ConfigMap ou Secret référencé introuvable
Terminating (Bloqué)
Le pod refuse de mourir
Finalizer bloqué, ou I/O disque NFS gelé
Diagnostic Avancé : Les Conteneurs Éphémères (kubectl debug)
Comment déboguer une image de production moderne ultra-sécurisée (Distroless / Scratch) qui ne contient ni sh, ni curl, ni ps ?
# Injecter un conteneur de debug avec tous vos outils sans redémarrer le pod !kubectl debug -it mon-pod-distroless --image=nicolaka/netshoot --target=mon-app
Le conteneur de debug partage le même namespace réseau et les mêmes processus que l'application !
Scène de Crime CSI N°1 : Le Crash Incompréhensible
Constat : Un conteneur Java SpringBoot redémarre toutes les 2 minutes sans aucun message d'erreur dans les logs applicatifs.
En tapant kubectl describe pod java-app :
Last State:     Terminated
  Reason:       OOMKilled
  Exit Code:    137
Diagnostic : La JVM a alloué son heap sans tenir compte de la limite cgroups K8s. Le noyau Linux a envoyé un SIGKILL (Code 137 = 128 + 9).
Correction : Ajouter l'option JVM -XX:MaxRAMPercentage=75.0 ou augmenter la limite mémoire dans le YAML.
Scène de Crime CSI N°2 : Le Pod Terminating Éternel
Constat : Vous tapez kubectl delete pod mon-pod --force, mais le Pod reste bloqué indéfiniment en statut Terminating.
# 1. Inspecter les finalizers qui retiennent la destructionkubectl get pod mon-pod -o jsonpath='{.metadata.finalizers}'# 2. Débloquer la situation en supprimant le finalizer bloquantkubectl patch pod mon-pod -p '{"metadata":{"finalizers":null}}'
Mini-Défi : Le Pod Qui Se Termine Immédiatement
Incident SRE : Vous lancez un pod avec l'image ubuntu:latest sans argument particulier : kubectl run test --image=ubuntu.
Le pod passe immédiatement en Completed puis en CrashLoopBackOff.
Pourquoi ce conteneur refuse-t-il de rester en vie ?
Mini-Défi : Le Pod Qui Se Termine Immédiatement
Incident SRE : Vous lancez un pod avec l'image ubuntu:latest sans argument particulier : kubectl run test --image=ubuntu.
Le pod passe immédiatement en Completed puis en CrashLoopBackOff.
Pourquoi ce conteneur refuse-t-il de rester en vie ?
Réponse : Le processus principal par défaut d'une image Ubuntu est /bin/bash. Sans terminal interactif (-it) ni commande longue (sleep infinity), le shell termine son exécution immédiatement (PID 1 s'arrête avec code 0), ce qui éteint le Pod.
Accéder à une base de données PostgreSQL ou une UI interne sans jamais exposer de port public sur Internet :
# Rediriger le port local 5432 vers le port 5432 du Pod postgreskubectl port-forward pod/postgres-0 5432:5432
# Rediriger vers un Service ou un Deploymentkubectl port-forward svc/prometheus-k8s 9090:9090 -n monitoring
Le trafic passe à travers le tunnel HTTPS chiffré de l'APIServer !
2. Automatisation CI/CD : kubectl wait
Fini les boucles sleep 30 fragiles et hasardeuses dans vos pipelines CI/CD !
# Attendre que le déploiement soit 100% opérationnel avec un timeout de 2 minuteskubectl rollout status deployment/bookstore-api --timeout=120s
# Attendre qu'une condition spécifique soit validéekubectl wait --for=condition=ready pod -l app=bookstore-api --timeout=60s
# Attendre la fin d'un Job de migration de base de donnéeskubectl wait --for=condition=complete job/db-migration --timeout=180s
3. Transfert de Données : kubectl cp
# Copier un fichier de log local vers un conteneurkubectl cp dump.sql default/postgres-0:/tmp/dump.sql
# Récupérer un fichier généré à l'intérieur d'un podkubectl cp default/reporting-pod:/app/report.pdf ./report.pdf -c app-container
Mini-Défi : Le Pipeline CI/CD Résilient
Objectif : Vous écrivez un script de déploiement qui applique un manifest, attend que l'application soit prête, et effectue un rollback automatique immédiat si le déploiement échoue au bout de 90 secondes.
Mini-Défi : Le Pipeline CI/CD Résilient
Objectif : Vous écrivez un script de déploiement qui applique un manifest, attend que l'application soit prête, et effectue un rollback automatique immédiat si le déploiement échoue au bout de 90 secondes.
# Le script SRE parfait :kubectl apply -f app-deployment.yaml
if ! kubectl rollout status deployment/web-app --timeout=90s;thenecho"Déploiement échoué ! Rollback immédiat..."kubectl rollout undo deployment/web-app
exit 1
fiecho"Déploiement réussi avec succès !"
KUBERNETES : Maintenance, Drains & Mises à Niveau
La Procédure de Maintenance d'un Nœud Sans Interruption
[ Nœud Actif avec Pods ] ──► [ 1. CORDON ] ──► Aucun nouveau pod n'est admis
                                   │
                                   ▼
                             [ 2. DRAIN ]  ──► Évacue les pods vers d'autres nœuds
                                   │           (En respectant les PDB !)
                                   ▼
                             [ 3. REBOOT / UPGRADE OS ]
                                   │
                                   ▼
                             [ 4. UNCORDON ] ──► Nœud réactivé et sain !
1. Cordon & Drain en Pratique
# Étape 1 : Empêcher le scheduling sur le nœudkubectl cordon worker-01
# Étape 2 : Évacuer tous les pods proprementkubectl drain worker-01 --ignore-daemonsets --delete-emptydir-data
# Étape 3 : Une fois la maintenance terminée (reboot, kernel patch...)kubectl uncordon worker-01
--ignore-daemonsets : Indispensable pour ne pas bloquer sur les agents locaux de logs/monitoring.
--delete-emptydir-data : Accepte la suppression des données locales temporaires.
2. Le Garde-Fou Absolu : PodDisruptionBudget (PDB)
Sans PDB, un drain peut tuer tous les réplicas d'un service en même temps et créer une coupure de service !
apiVersion: policy/v1kind: PodDisruptionBudgetmetadata:name: bookstore-pdbspec:minAvailable: 2 # Garantit qu'au moins 2 pods restent vivants en permanence !selector:matchLabels:app: bookstore
Le kubectl drain sera mis en attente et évincera les pods un par un, en attendant que le nouveau pod soit Ready avant de tuer le suivant.
3. Stratégie de Mise à Niveau du Cluster (kubeadm)
1. Mettre à niveau le Control Plane Master 1
$ sudo apt update &&sudo apt install -y kubeadm=1.31.0-1.1
$ sudo kubeadm upgrade plan
$ sudo kubeadm upgrade apply v1.31.0
$ sudo apt install -y kubelet=1.31.0-1.1 kubectl=1.31.0-1.1
$ sudo systemctl daemon-reload &&sudo systemctl restart kubelet
│
▼
2. Mettre à niveau les Worker Nodes (Un par Un !)
$ kubectl drain worker-01 ...
$ sudo kubeadm upgrade node
$ sudo apt install -y kubelet=1.31.0-1.1
$ sudo systemctl restart kubelet
$ kubectl uncordon worker-01
4. Sauvegarde & Disaster Recovery avec Velero
Velero (CNCF) : L'outil standard de sauvegarde et de migration de clusters.
Sauvegarde la totalité des manifests dans un bucket S3/GCS et déclenche des snapshots des disques persistants (CSI).
# Sauvegarder tout le namespace production en 1 commandevelero backup create prod-backup-$(date +%F) --include-namespaces production
# Restaurer l'environnement complet en cas de désastrevelero restore create --from-backup prod-backup-2026-08-25
Mini-Défi : Le Drain Bloqué
Incident SRE : Vous lancez kubectl drain worker-02, mais la commande reste bloquée indéfiniment avec le message : Cannot evict pod: PodDisruptionBudget "api-pdb" is currently violated.
Quel est le problème et comment le résoudre proprement ?
Mini-Défi : Le Drain Bloqué
Incident SRE : Vous lancez kubectl drain worker-02, mais la commande reste bloquée indéfiniment avec le message : Cannot evict pod: PodDisruptionBudget "api-pdb" is currently violated.
Quel est le problème et comment le résoudre proprement ?
Réponse : L'application a un PDB exigeant minAvailable: 2, mais il n'y a plus assez de place sur les autres nœuds du cluster pour démarrer le second pod. Solution : Ajouter un nouveau worker node au cluster ou augmenter temporairement les ressources disponibles pour débloquer l'éviction.
Les vieux PodSecurityPolicy (PSP) sont dépréciés. Le standard moderne est Pod Security Admission :
Profil PSS
Niveau de Sécurité
Restrictions Imposées
Privileged
Insecure
Accès complet sans restriction (réservé aux CNI / CSI)
Baseline
Standard
Interdit les conteneurs privilégiés et accès hostPath critiques
Restricted
Durci (Prod)
Non-root obligatoire, capabilities supprimées, FS en lecture seule
# Activer le mode Restricted sur un namespace en 1 commande :kubectl label namespace production \
pod-security.kubernetes.io/enforce=restricted \
pod-security.kubernetes.io/warn=restricted
3. Durcissement du Pod : SecurityContext
spec:securityContext:runAsNonRoot: true # Interdit l'exécution sous root (UID 0)seccompProfile:type: RuntimeDefault # Active le filtrage des appels systèmecontainers:-name: appimage: my-app:distrolesssecurityContext:allowPrivilegeEscalation: falsereadOnlyRootFilesystem: true # Empêche l'écriture de malwarecapabilities:drop:["ALL"]# Supprime toutes les capacités Linux
4. Network Policies : Le Pare-feu Interne (Zero Trust)
Par défaut dans Kubernetes, tous les Pods peuvent parler à tous les Pods !
# Règle d'or : Bloquer tout le trafic entrant par défaut (Default Deny)apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata:name: default-deny-ingressnamespace: productionspec:podSelector:{}# S'applique à tous les pods du namespacepolicyTypes:- Ingress
# N'autoriser QUE le Backend à parler à PostgreSQL sur le port 5432apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata:name: allow-backend-to-postgresspec:podSelector:matchLabels:app: postgresingress:-from:-podSelector:matchLabels:app: bookstore-backendports:-protocol: TCPport: 5432
Mini-Défi : L'Erreur d'Audit de Sécurité
Question flash : Quelle commande kubectl permet de vérifier immédiatement si l'utilisateur alice a le droit de supprimer des secrets dans le namespace production ?
Mini-Défi : L'Erreur d'Audit de Sécurité
Question flash : Quelle commande kubectl permet de vérifier immédiatement si l'utilisateur alice a le droit de supprimer des secrets dans le namespace production ?
# La réponse instantanée :kubectl auth can-i delete secrets -n production --as alice
KUBERNETES : Gestion de Paquets avec Helm
Pourquoi Helm ? Le Package Manager Cloud Native
 [ 20 Fichiers YAML Complexes ]  ──► Packagés dans un  ──► [ 1 Helm Chart ]
 (Deployments, Services, RBAC,                             (my-app:1.2.0)
  CRDs, Ingress, Secrets...)                                     │
                                                                 ▼
                         Paramétré par un seul fichier : [ values.yaml ]
Rôle principal : Idéal pour déployer et maintenir des applications tierces (Prometheus, cert-manager, Ingress-NGINX, Redis).
Maintient un historique des versions déployées et gère les rollbacks en 1 commande.
Anatomie d'un Helm Chart
my-chart/
├── Chart.yaml          # Métadonnées (Nom, version de l'app, version du chart)
├── values.yaml         # Valeurs par défaut injectées dans les templates
├── templates/          # Gabarits YAML avec moteur Go Template
│   ├── deployment.yaml
│   ├── service.yaml
│   └── _helpers.tpl
└── charts/             # Sous-charts / Dépendances éventuelles
# values.yaml (Dev vs Prod)service:type: ClusterIPport: 8080
Commandes Indispensables du Quotidien
# 1. Ajouter un dépôt officiel (ex: Bitnami)helm repo add bitnami https://charts.bitnami.com/bitnami
helm repo update
# 2. Installer ou Mettre à jour de façon idempotentehelm upgrade --install my-redis bitnami/redis \
--namespace databases --create-namespace \
--set auth.enabled=false
# 3. Tester le rendu YAML sans rien appliquer (Dry Run)helm template my-release bitnami/redis -f my-values.yaml
# 4. Rollback immédiat vers la révision précédentehelm rollback my-redis 1
Mini-Défi : Le Piège du Template YAML
Code Review : Que se passe-t-il si vous passez une chaîne de caractères contenant des deux-points (:) dans une valeur Helm sans guillemets dans votre values.yaml ?
Code Review : Que se passe-t-il si vous passez une chaîne de caractères contenant des deux-points (:) dans une valeur Helm sans guillemets dans votre values.yaml ?
Réponse : Le parseur YAML interprète la seconde partie comme une nouvelle clé imbriquée invalide et le helm install crashe. Il faut toujours quoter les chaînes : message: "Erreur: Connexion refusée" et utiliser la fonction {{ .Values.message | quote }} dans le template.
KUBERNETES : Configuration Déclarative avec Kustomize
Le Concept : Personnaliser Sans Moteur de Templates
Principe fondamental : Pas de syntaxe {{ .Values }} complexe. On part de manifests YAML purs et standards, et on applique des correctifs (patches) chirurgicaux par environnement.
Intégré nativement dans kubectl depuis la version 1.14 (kubectl apply -k).
Fonctionnalité magique : Kustomize calcule un hash SHA du contenu du fichier (ex: app-config-7b2m8f4k9g).
Lorsque vous modifiez config.properties, le nom du ConfigMap change, ce qui force Kubernetes à déclencher automatiquement un Rolling Update propre de tous les Pods sans manipulation manuelle !
Helm vs Kustomize : Le Tableau Décisionnel
Critère
Helm
Kustomize
Philosophie
Templating Go paramétré
Héritage & Patches déclaratifs
Dépendance externe
Binaire helm requis
Intégré dans kubectl
Gestion des Secrets / CM
Manuelle
Hash automatique (Rolling update forcé)
Cas d'usage Idéal
Applications tierces CNCF (Ingress, Cert-Manager)
Vos propres microservices internes en GitOps
Mini-Défi : Déploiement Kustomize
# Quelle commande permet d'inspecter le rendu final de l'overlay production sans rien appliquer ?kubectl kustomize overlays/production/
# Quelle commande permet d'appliquer directement l'overlay en production ?kubectl apply -k overlays/production/
KUBERNETES : Industrialisation GitOps avec ArgoCD
Qu'est-ce que le GitOps ?
          APPROCHE CI CLASSIQUE                     APPROCHE GITOPS (ArgoCD)
  [ Runner CI / GitHub Actions ]              [ Git Repository (Source of Truth) ]
                │ (Push)                                       │
                ▼ (Droits admin requis !)                      ▼ (Pull & Reconcile)
       [ Cluster Kubernetes ]                       [ ArgoCD dans le Cluster ]
  (Sécurité faible : tokens exposés)            (Sécurité maximale : 0 port ouvert !)
Les 4 Principes OpenGitOps :
Déclaratif : Tout le système est décrit en YAML.
Versionné & Immuable : Git est l'unique source de vérité (Single Source of Truth).
Tiré Automatiquement : Le cluster tire les changements depuis Git (Pull model).
Réconcilié en Continu : ArgoCD répare automatiquement toute dérive manuelle (Self-Healing).
1. L'Objet Application d'ArgoCD
apiVersion: argoproj.io/v1alpha1kind: Applicationmetadata:name: bookstore-productionnamespace: argocdspec:project: defaultsource:repoURL: https://github.com/mon-orga/k8s-manifests.gittargetRevision: mainpath: overlays/productiondestination:server: https://kubernetes.default.svcnamespace: productionsyncPolicy:automated:prune: true # Supprime du cluster les objets supprimés dans Git !selfHeal: true # Annule et réécrit toute modification manuelle directe faite via kubectl !
2. Le Tableau de Bord & les Statuts ArgoCD
  SYNC STATUS                              HEALTH STATUS
┌───────────────┐                        ┌───────────────┐
│ Synced        │ (Cluster == Git)       │ Healthy       │ (Tous les pods sont Ready)
│ OutOfSync     │ (Git a changé)         │ Progressing   │ (Rolling update en cours)
│ Unknown       │ (Erreur de parsing)    │ Degraded      │ (CrashLoopBackOff / Erreur)
└───────────────┘                        └───────────────┘
Drift Correction (Self-Healing) : Si un développeur supprime un Pod ou modifie un Service avec kubectl edit en production, ArgoCD détecte l'écart en quelques secondes et rétablit immédiatement l'état déclaré dans Git !
3. Gestion Multi-Clusters : ApplicationSet
Pour gérer 100 applications réparties sur 10 clusters (Dev, Staging, Prod, Multi-Cloud) sans dupliquer 1000 lignes de YAML :
Scénario de test : Vous avez configuré une Application ArgoCD avec syncPolicy.automated.selfHeal: true. Un administrateur supprime accidentellement un Deployment avec kubectl delete deployment bookstore-api.
Que se passe-t-il dans les 10 secondes qui suivent ?
Mini-Défi : L'Effet du Self-Healing
Scénario de test : Vous avez configuré une Application ArgoCD avec syncPolicy.automated.selfHeal: true. Un administrateur supprime accidentellement un Deployment avec kubectl delete deployment bookstore-api.
Que se passe-t-il dans les 10 secondes qui suivent ?
Réponse : ArgoCD détecte que le Deployment manque dans le cluster par rapport à la branche main de Git, et le recrée instantanément à l'identique !.




Comment Évolue Kubernetes ? Les SIGs
Le projet est piloté par des Special Interest Groups (SIGs) autonomes :